Что такое микроразметка Schema.org
Микроразметка Schema.org — стандартизированный семантический словарь типов и свойств, встраиваемый в код веб-страницы для явного связывания видимого контента с формализованными сущностями, которые распознаются поисковыми роботами.
Принцип работы технологии базируется на трансляции человекочитаемого контента в машиночитаемый формат. Когда пользователь открывает страницу, браузер рендерит визуальные элементы: текст, изображения, кнопки. Поисковый робот при сканировании анализирует исходный код. Без структурированных данных краулер видит просто набор HTML-тегов и текстовых узлов, пытаясь алгоритмически определить их смысл. Внедрение словаря меняет этот процесс: из общего массива данных выделяется конкретный объект, которому присваивается строгий тип.
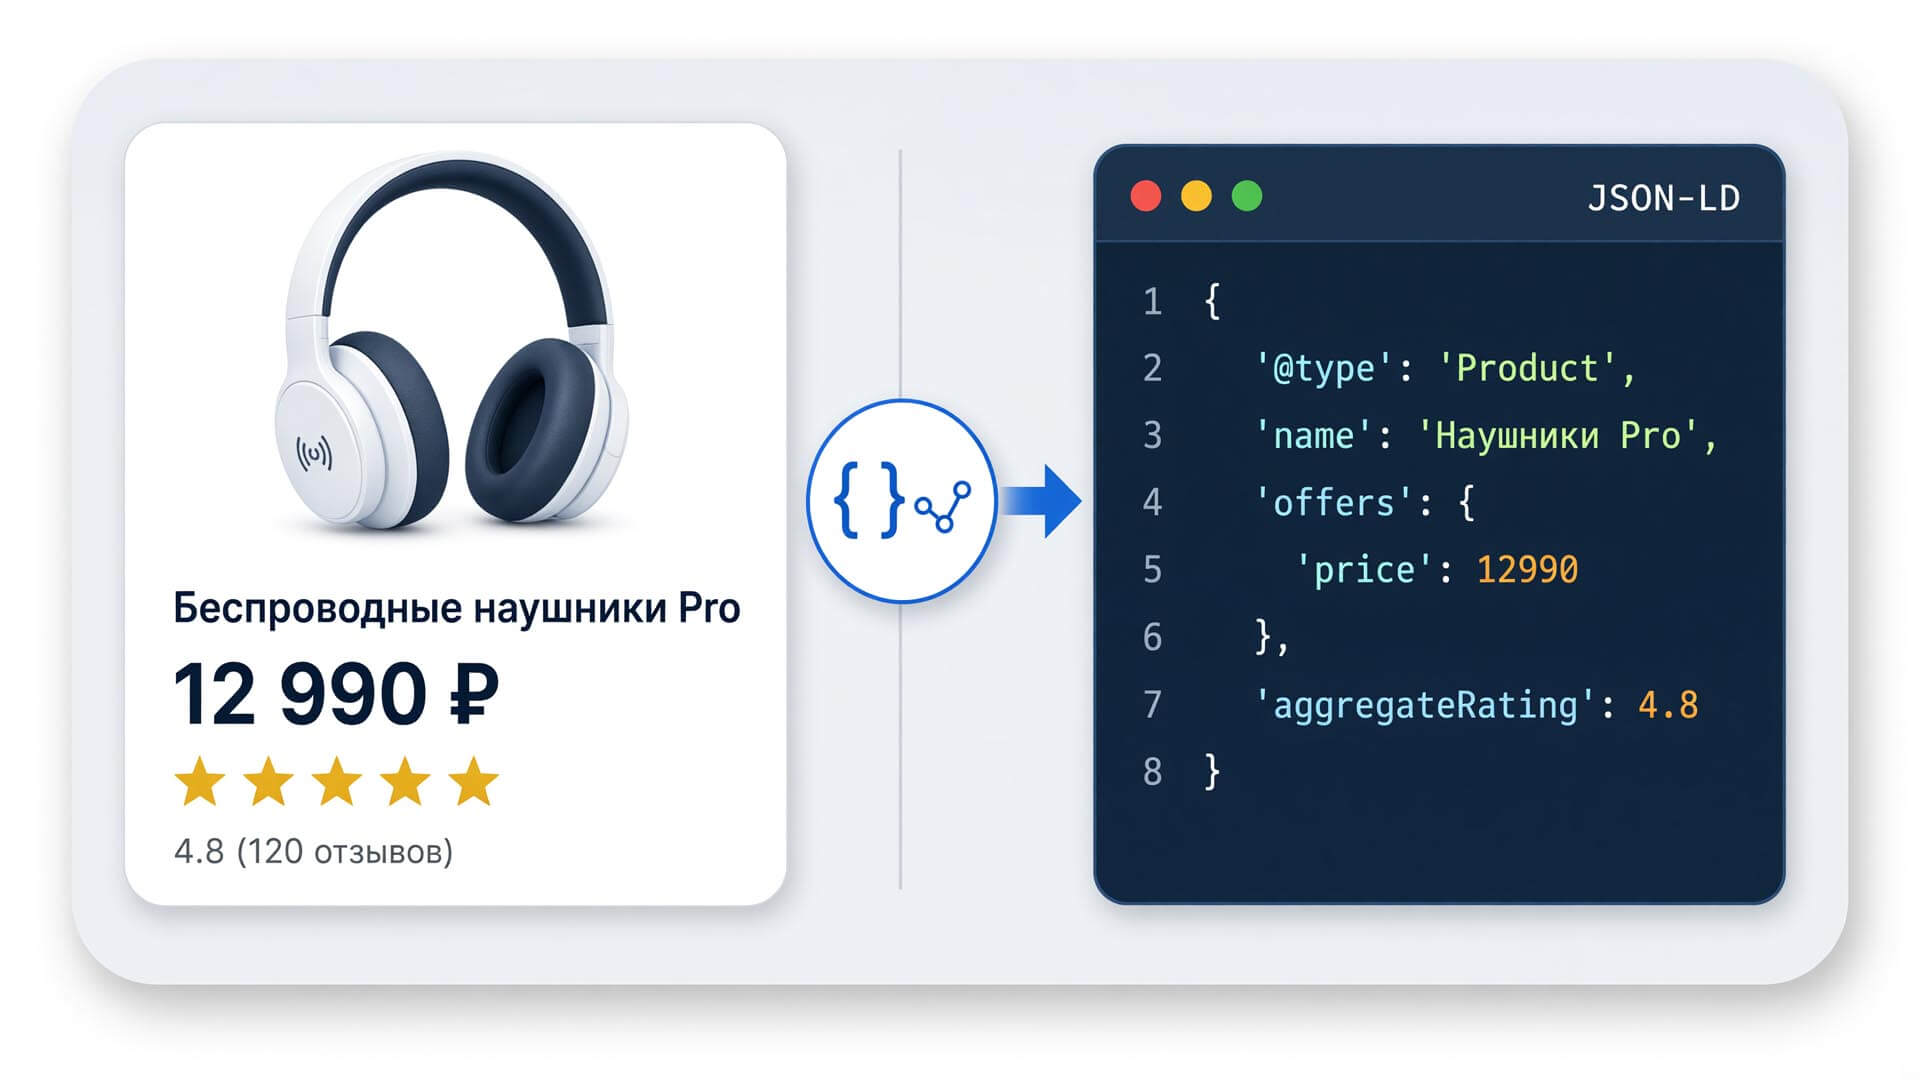
Технически процесс выглядит как создание ассоциативного массива. Объекту назначается идентификатор типа, после чего отдельные фрагменты контента сопоставляются со свойствами сущности. Робот получает готовую структуру данных формата «сущность — атрибут — значение». Поисковая система перестает угадывать назначение цифр на странице товара, точно зная, что конкретное число обозначает цену в определенной валюте, а соседнее число отражает складской остаток.
Семантическая разметка Schema.org поддерживает сотни различных онтологий, описывающих практически любые объекты реального и виртуального мира. Словарь постоянно обновляется консорциумом W3C и представителями крупнейших поисковых систем. На практике коммерческим проектам редко требуется использовать весь доступный арсенал. Базовый набор из нескольких ключевых типов покрывает абсолютное большинство задач стандартного интернет-магазина, корпоративного портала или информационного ресурса.
Понимание того, что такое Schema.org, требует осознания разницы между визуальным представлением и структурой данных. Визуально карточка товара содержит фотографию, текстовый заголовок, перечеркнутую старую цену и блок отзывов. На уровне машиночитаемого кода это единый объект, внутри которого вложены сущности предложения, рейтинга и комментариев. Подобная иерархия позволяет поисковым алгоритмам извлекать точные факты для формирования ответов на сложные запросы пользователей.
Зачем нужны структурированные данные
Основная техническая выгода от корректного структурирования информации заключается в получении расширенных сниппетов (Rich Results) в поисковой выдаче. Стандартный сниппет состоит из заголовка, ссылки и краткого описания. Расширенный результат дополняется визуальными и информационными триггерами: звездным рейтингом, актуальной ценой, статусом наличия на складе, миниатюрой изображения или навигационной цепочкой. Подобное оформление радикально выделяет ссылку на фоне конкурентов.
Аналитические исследования показывают прямую корреляцию между наличием расширенного сниппета и ростом кликабельности (CTR). Страницы с корректно настроенными товарными сущностями демонстрируют прирост переходов из поиска на десятки процентов. Пользователь получает ключевую коммерческую информацию до перехода на сайт, что снижает показатель отказов и повышает конверсионность трафика. Человек кликает по ссылке, уже зная цену и рейтинг продукта.
В контексте mobile-first индексации структурирование данных приобретает критическое значение. При сканировании мобильных версий сайтов поисковые роботы ограничены в ресурсах на рендеринг сложных JavaScript-интерфейсов. Наличие готового машиночитаемого кода позволяет краулеру мгновенно считать контекст страницы без необходимости полной отрисовки DOM-дерева. Это ускоряет индексацию обновлений ассортимента и изменения цен.
Развитие генеративного поиска (AI Overviews) также опирается на формализованные данные. Нейросетевые алгоритмы формируют прямые ответы на основе фактов, извлеченных из авторитетных источников. Хотя представители поисковых систем отмечают, что микроразметка Schema.org не выступает обязательным условием для попадания в AI-ответы, наличие четко размеченных сущностей снижает риск галлюцинаций нейросети и повышает вероятность цитирования источника.
Важно
Структурированные данные не выступают прямым фактором ранжирования. Наличие идеального кода не поднимет некачественную страницу в топ выдачи. Технология дает право на формирование расширенного сниппета, который повышает кликабельность. Рост позиций происходит косвенно, за счет улучшения поведенческих метрик и более точного понимания контекста алгоритмами.
Интеграция словарей становится неотъемлемой частью комплексной технической оптимизации. Применяя современные методы продвижения сайтов, инженеры закладывают генерацию машиночитаемого кода еще на этапе проектирования архитектуры проекта, синхронизируя вывод визуального контента с формированием скрытых структур данных.
Основные форматы и виды словарей
Актуальные виды микроразметки Schema.org позволяют описать практически любую информационную или коммерческую единицу. Из сотен доступных вариантов выделяется пул базовых онтологий, обязательных для внедрения на коммерческих проектах. Игнорирование этих форматов приводит к потере конкурентного преимущества в поисковой выдаче.
- Organization — описывает компанию как юридическое лицо и бренд. Включает официальное название, альтернативные имена, логотип, контактные данные, физический адрес штаб-квартиры и ссылки на официальные профили в социальных сетях.
- WebSite — формализует сам веб-ресурс. Часто используется в связке со свойством SearchAction, что активирует строку поиска по сайту непосредственно в сниппете поисковой системы.
- BreadcrumbList — структурирует навигационную цепочку (хлебные крошки). Позволяет поисковику выводить в сниппете понятный путь по разделам каталога вместо длинного и нечитабельного URL-адреса.
- Product — детализирует карточку товара. Передает алгоритмам точное наименование, артикул, идентификаторы (GTIN, ISBN), бренд и ссылку на основное изображение продукта.
- Offer — коммерческое предложение, неразрывно связанное с товаром. Содержит критически важные свойства: стоимость, код валюты, состояние товара и статус наличия на складе.
- LocalBusiness — специализированный подтип организации для локального бизнеса. Дополняет базовые данные географическими координатами, часами работы, зоной обслуживания и диапазоном цен.
- Article — описывает редакционный контент, новости и записи блогов. Передает заголовок, дату первоначальной публикации, дату последнего обновления, информацию об авторе и издателе.
Перечисленные типы формируют фундамент семантического веба для бизнеса. По мере масштабирования проекта внедряются узкоспециализированные форматы: рецепты, вакансии, мероприятия, программное обеспечение или обучающие курсы.
Сравнение синтаксисов передачи данных
Словарь определяет набор сущностей и свойств, но для передачи этих данных в HTML-документ требуется синтаксис. Исторически сложилось три основных формата: Microdata, RDFa и JSON-LD. Поисковые системы способны обрабатывать все три варианта, однако технические требования и рекомендации разработчиков существенно различаются.
Microdata предполагает встраивание атрибутов непосредственно в HTML-теги. Разработчику приходится добавлять свойства к существующим блокам верстки. Это жестко связывает визуальное представление со структурой данных. Любое изменение дизайна или рефакторинг верстки может сломать машиночитаемый код. Кроме того, обилие дополнительных атрибутов увеличивает размер DOM-дерева, замедляя рендеринг страницы в браузере.
RDFa работает по схожему принципу, расширяя HTML атрибутами для связи данных. Формат обладает высокой гибкостью, но отличается сложным синтаксисом, что делает его непопулярным среди веб-мастеров. Поддержка RDFa сохраняется преимущественно для обеспечения обратной совместимости со старыми государственными или научными порталами.
JSON-LD (JavaScript Object Notation for Linked Data) представляет собой независимый блок кода, который размещается внутри тега script. Данные передаются в формате ассоциативных массивов JSON. Код полностью изолирован от визуальной верстки. Разработчик может свободно менять HTML-структуру, не опасаясь повредить семантические связи. Именно этот формат официально рекомендуется поисковыми системами для новых внедрений.
| Параметр | JSON-LD | Microdata |
|---|---|---|
| Рекомендация поисковых систем | Приоритетный стандарт для всех новых проектов | Поддерживается как устаревающее наследие (legacy) |
| Сложность внедрения | Низкая: изолированный блок кода, легко генерируется на бэкенде | Высокая: требует точечной модификации множества HTML-узлов |
| Влияние на верстку HTML | Отсутствует: скрипт не взаимодействует с визуальными элементами | Критичное: жесткая привязка атрибутов к структуре DOM-дерева |
| Скорость загрузки (влияние на DOM) | Минимальное: браузер быстро парсит скрипт без блокировки рендеринга | Негативное: раздувание тегов увеличивает время построения дерева |
Востребованные типы для бизнеса
Глубокое понимание спецификаций отдельных типов позволяет извлекать максимум пользы из технологии. Формат Article не имеет строго обязательных свойств, что подтверждается актуальной документацией. Однако для получения расширенного представления рекомендуется передавать массив данных: заголовок, массив изображений с разным соотношением сторон, точные временные метки публикации и модификации. Указание автора через вложенную сущность Person повышает уровень доверия к материалу.
Спецификация Product требует предельной точности. Товарная сущность бессмысленна без вложенного объекта Offer. Поисковые алгоритмы строго проверяют наличие цены и валюты. Отсутствие этих полей вызывает критическую ошибку валидации. Дополнительно рекомендуется передавать свойство aggregateRating — сводную оценку на основе отзывов покупателей. Именно наличие звезд рейтинга обеспечивает максимальный прирост кликабельности товарного сниппета.
Формат FAQPage предназначен для разметки страниц, содержащих список часто задаваемых вопросов и ответов на них. Структура требует использования свойства mainEntity, внутри которого размещается массив объектов Question. Каждый вопрос обязан содержать вложенный объект Answer с текстовым ответом. Корректная настройка этого типа позволяет занимать нулевую позицию в выдаче, предоставляя пользователю ответ прямо на странице результатов поиска.
Сущность Organization служит цифровым паспортом компании. Минимальный набор включает название, ссылку на главную страницу, URL логотипа и контактный телефон. Для локальных предприятий используется расширение LocalBusiness, где критически важно указать физический адрес через объект PostalAddress и географические координаты через GeoCoordinates. Это обеспечивает корректное отображение компании на картах и в локальных блоках выдачи.
При проектировании структуры данных для интернет-магазина критически важно связывать сущности между собой. Товар не должен висеть в вакууме. Объект Product должен ссылаться на бренд через свойство brand, а сам бренд описываться как Organization. Такая вложенность формирует полноценный граф знаний, который поисковые системы обрабатывают гораздо эффективнее плоских списков.
Пошаговое внедрение кода на сайт
Процесс интеграции машиночитаемого кода требует строгой последовательности действий. Хаотичное добавление скриптов приводит к конфликтам данных и пессимизации сниппетов. Внедрение микроразметки Schema.org начинается с аналитики и заканчивается техническим мониторингом.
Первый этап — аудит контента. Инженер определяет тип страницы и подбирает соответствующую сущность из словаря. Недопустимо размечать информационную статью как товар, пытаясь получить коммерческий сниппет. Поисковые алгоритмы легко распознают подобные манипуляции и блокируют вывод расширенных результатов для всего домена.
Второй этап — сбор переменных. Специалист составляет карту соответствия: какие визуальные элементы страницы будут переданы в свойства JSON-объекта. Важнейшее правило гласит: машиночитаемый код обязан строго соответствовать видимому контенту. Если в скрипте указана цена со скидкой, а пользователь видит полную стоимость, это классифицируется как спам.
Третий этап — генерация синтаксиса. В зависимости от технологического стека проекта, код формируется вручную, через сторонние сервисы или средствами серверной логики CMS. Сформированный блок скрипта интегрируется в исходный код страницы. Допускается размещение как в секции head, так и в теле документа перед закрывающим тегом body.
Четвертый этап — многоуровневое тестирование. До выкатки изменений на рабочий сервер код прогоняется через валидаторы. Проверяются синтаксическая целостность JSON-массива и соответствие логике поисковых систем. Только после устранения всех предупреждений код деплоится на продакшен.
Пятый этап — инициация сканирования. После обновления шаблонов необходимо принудительно отправить приоритетные URL-адреса на переобход через панели для веб-мастеров. Это ускоряет процесс обновления кэша поисковых систем и появление новых сниппетов в выдаче.
Микроразметка сайта Schema.org требует регулярного аудита. Изменения в верстке, обновление плагинов или модификация контента могут нарушить передачу переменных в скрипт. Постоянный мониторинг позволяет оперативно выявлять и устранять технические сбои до того, как они повлияют на поисковый трафик.
Генерация скриптов вручную
Для небольших проектов, лендингов или сайтов-визиток автоматизация не всегда рентабельна. В таких случаях применяется ручная генерация кода с использованием специализированных веб-инструментов. Эти сервисы предоставляют графический интерфейс, где пользователь заполняет поля формы, а система на лету формирует валидный JSON-LD-скрипт.
Популярные генераторы обладают схожей логикой работы. Пользователь выбирает нужную онтологию из выпадающего списка. На экране появляются поля для ввода данных: заголовок, описание, ссылки на изображения, цены. По мере заполнения полей в соседнем окне генерируется код. Готовый скрипт копируется в буфер обмена и вставляется в HTML-код целевой страницы через панель администратора или FTP-клиент.
Ручной метод исключает ошибки синтаксиса, так как генераторы автоматически расставляют кавычки, запятые и фигурные скобки. Однако подход имеет существенный недостаток: статичность. Если цена товара изменится, веб-мастеру придется заново генерировать скрипт и вручную обновлять код на странице. Поэтому ручная генерация применяется исключительно для статических страниц: контактов, информации о компании или вечнозеленых статей.
Интеграция через Google Tag Manager
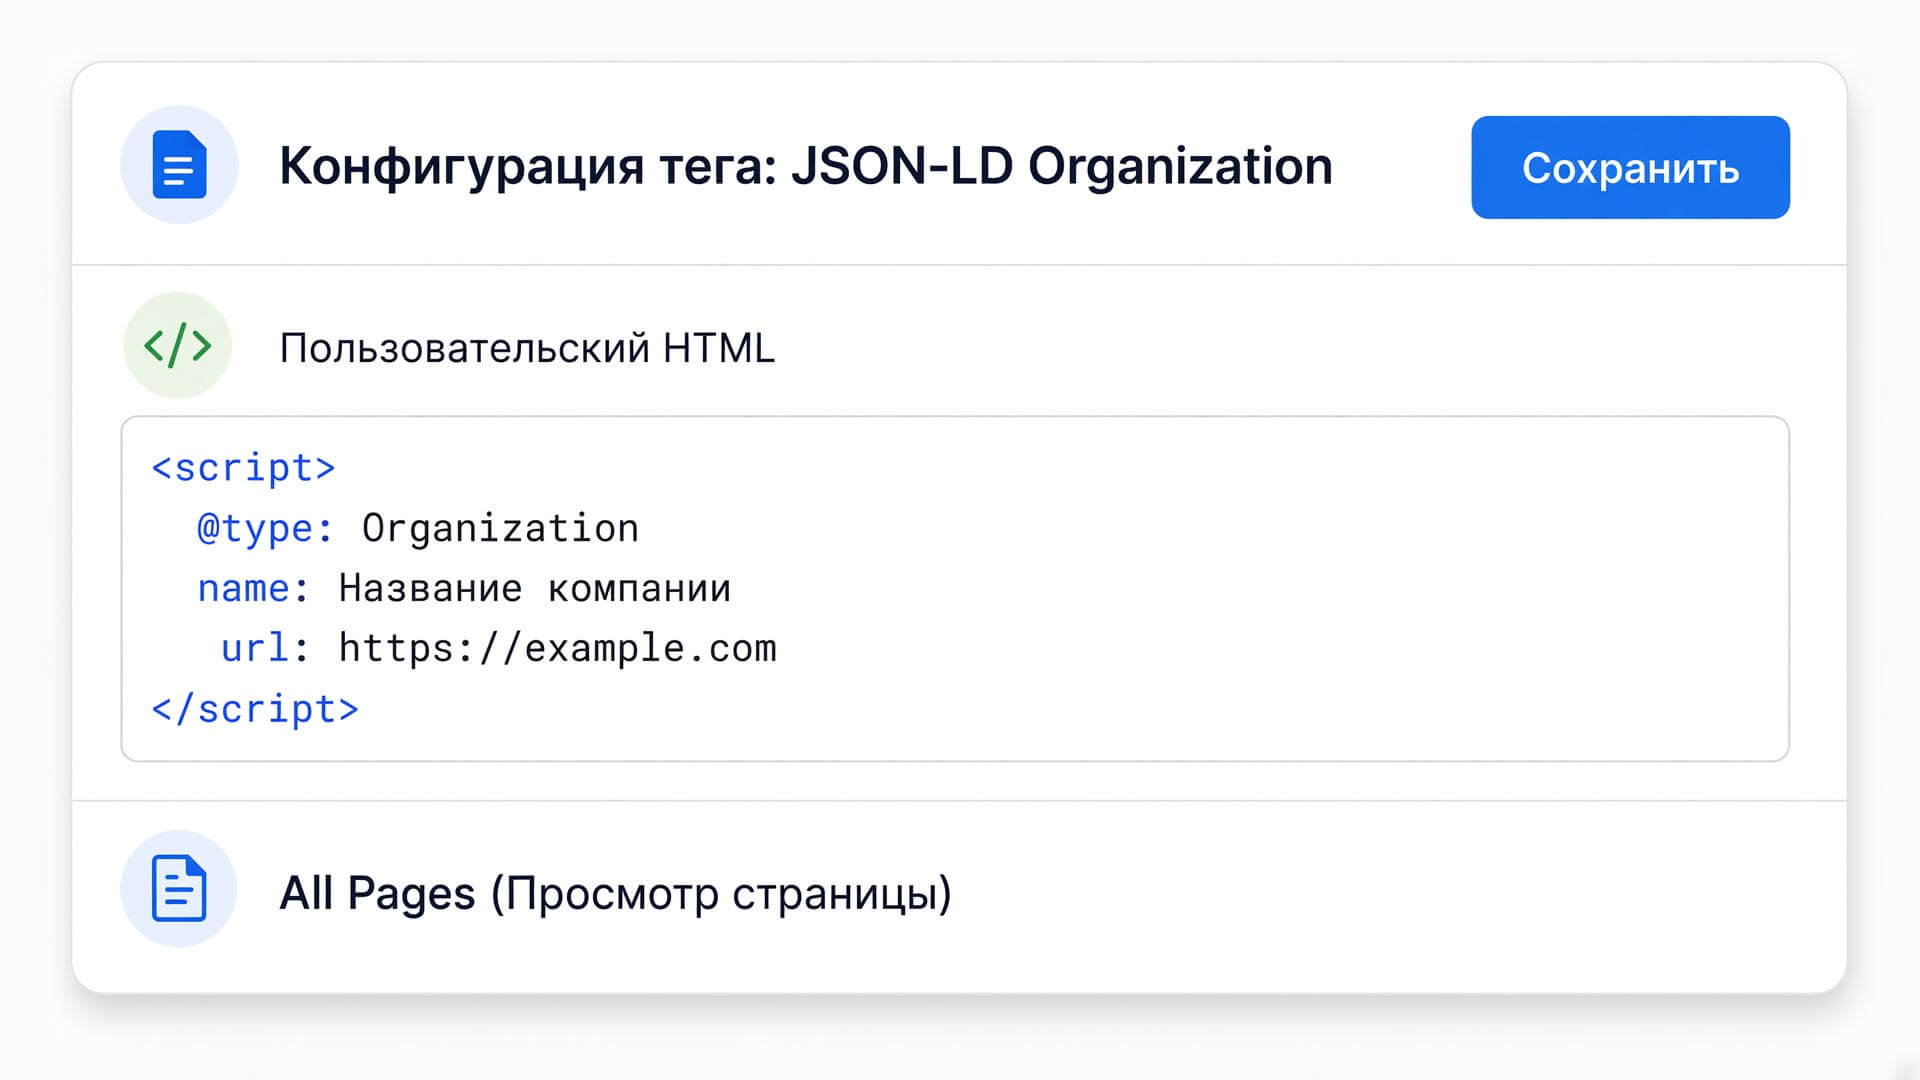
Использование диспетчера тегов предоставляет маркетологам инструмент для развертывания скриптов без привлечения backend-разработчиков. Метод базируется на создании пользовательского HTML-тега внутри контейнера GTM. В текстовое поле тега вставляется заранее подготовленный код JSON-LD, обернутый в стандартные теги script.
Ключевой момент настройки — выбор правильного триггера активации. Тег должен срабатывать на событие просмотра страницы (Page View). Можно настроить глобальную активацию для всех URL или ограничить срабатывание конкретными разделами сайта с помощью регулярных выражений. После публикации контейнера скрипт начинает внедряться в DOM-дерево при загрузке страницы.
Технический нюанс данного метода заключается в механике клиентского рендеринга. GTM инжектирует код посредством выполнения JavaScript в браузере пользователя. Поисковый робот должен обладать ресурсами для выполнения JS, чтобы обнаружить внедренные данные. Современные краулеры успешно справляются с этой задачей, однако для критически важных коммерческих сущностей (товары, цены) эксперты рекомендуют использовать серверный рендеринг, чтобы исключить риск потери данных при сбоях выполнения скриптов.
Автоматизация модулями для CMS
Масштабируемые проекты требуют полной автоматизации процесса. В системах управления контентом (CMS) задача решается на уровне серверной логики. Специализированные SEO-модули или встроенные функции ядра динамически формируют машиночитаемый код в момент генерации HTML-страницы сервером.
Логика работы плагинов базируется на маппинге (сопоставлении) переменных. Модуль обращается к базе данных CMS, извлекает значения полей конкретной записи и подставляет их в шаблон JSON-LD. Например, в системе WordPress популярные SEO-плагины автоматически берут заголовок поста (H1), URL миниатюры записи, имя автора из профиля пользователя и дату публикации, формируя идеальную сущность Article без участия редактора.
Для платформ электронной коммерции, таких как Shopify или «1С-Битрикс», автоматизация охватывает товарные каталоги. Компонент каталога при выводе карточки товара собирает массив данных: текущую цену с учетом активных скидок, остаток на складе, средний балл из модуля отзывов. Эти данные конвертируются в JSON-строку и выводятся в секции head. При изменении цены в базе данных, скрипт на странице обновляется мгновенно, обеспечивая поисковых роботов 100 % актуальной информацией.
Специфика разметки мобильных приложений
Продвижение программных продуктов и мобильных утилит требует использования специализированной онтологии SoftwareApplication. Этот тип данных информирует поисковые алгоритмы о том, что страница посвящена не просто статье или товару, а загружаемому приложению. Корректное заполнение свойств позволяет получить расширенный сниппет с кнопкой установки, рейтингом и указанием платформы, что критически важно для ASO (App Store Optimization) и мобильного маркетинга.
Спецификация требует точного заполнения ряда уникальных свойств. Свойство operatingSystem определяет совместимые платформы. Значения передаются в текстовом формате, например «Android 14» или «iOS 17». Допускается передача массива строк, если продукт кроссплатформенный. Это свойство помогает поисковику фильтровать выдачу в зависимости от устройства пользователя, скрывая iOS-приложения от владельцев Android-смартфонов.
Свойство applicationCategory классифицирует программный продукт. Здесь кроется частая ошибка разработчиков: попытка передать произвольную текстовую строку. Алгоритмы требуют использования строгих перечислений (enums) из утвержденного списка. Допустимые значения включают GameApplication, BusinessApplication, UtilitiesApplication и другие стандартизированные категории. Использование невалидного значения приводит к игнорированию всего блока данных.
Свойство aggregateRating отвечает за вывод звездного рейтинга. Для мобильных приложений этот визуальный триггер является главным фактором принятия решения о клике. Сводная оценка должна динамически подтягиваться из базы данных отзывов на сайте или транслироваться через API из официальных магазинов приложений. Искусственное завышение рейтинга в коде, не подтвержденное видимыми отзывами на странице, быстро пессимизируется алгоритмами антиспама.
Стоит запомнить
При разметке программного обеспечения свойство applicationCategory принимает только фиксированные значения из официальной документации. Любая опечатка или использование нестандартной категории (например, SuperApp) приведет к ошибке парсинга, и расширенный сниппет приложения не будет сформирован в результатах поиска.
Инструменты и методы валидации
Написание кода — лишь половина задачи. Обязательным этапом цикла разработки выступает валидация. Ошибка в одном символе, пропущенная запятая или незакрытая фигурная скобка в JSON-массиве делают весь скрипт нечитаемым для парсера. Поисковый робот просто проигнорирует поврежденный блок. Чтобы понять, как проверить микроразметку Schema, необходимо различать задачи синтаксического анализа и проверки на соответствие требованиям конкретных поисковиков.
Процесс валидации разделяется на два этапа: локальная отладка до публикации и глобальный мониторинг после индексации. Для локальной отладки используются веб-инструменты, позволяющие вставить фрагмент кода или указать URL тестового сервера. Они мгновенно подсвечивают синтаксические аномалии и логические нестыковки в иерархии сущностей.
Важно понимать разницу между стандартами консорциума и правилами поисковых систем. Код может быть абсолютно валидным с точки зрения синтаксиса JSON-LD и словаря Schema.org, но при этом не формировать расширенный сниппет, так как в нем отсутствуют поля, которые конкретная поисковая система считает обязательными для данного типа контента.
Мониторинг статуса в Search Console
Для проверки синтаксиса и семантики используется Schema Markup Validator. Этот инструмент парсит код и проверяет его на соответствие глобальным стандартам словаря. Он не оценивает шансы на получение сниппета, его задача — подтвердить, что структура данных технически корректна. Инструмент Google Rich Results Test решает бизнес-задачу: он анализирует код по внутренним алгоритмам поисковика и прямо сообщает, имеет ли страница право на формирование расширенных результатов.
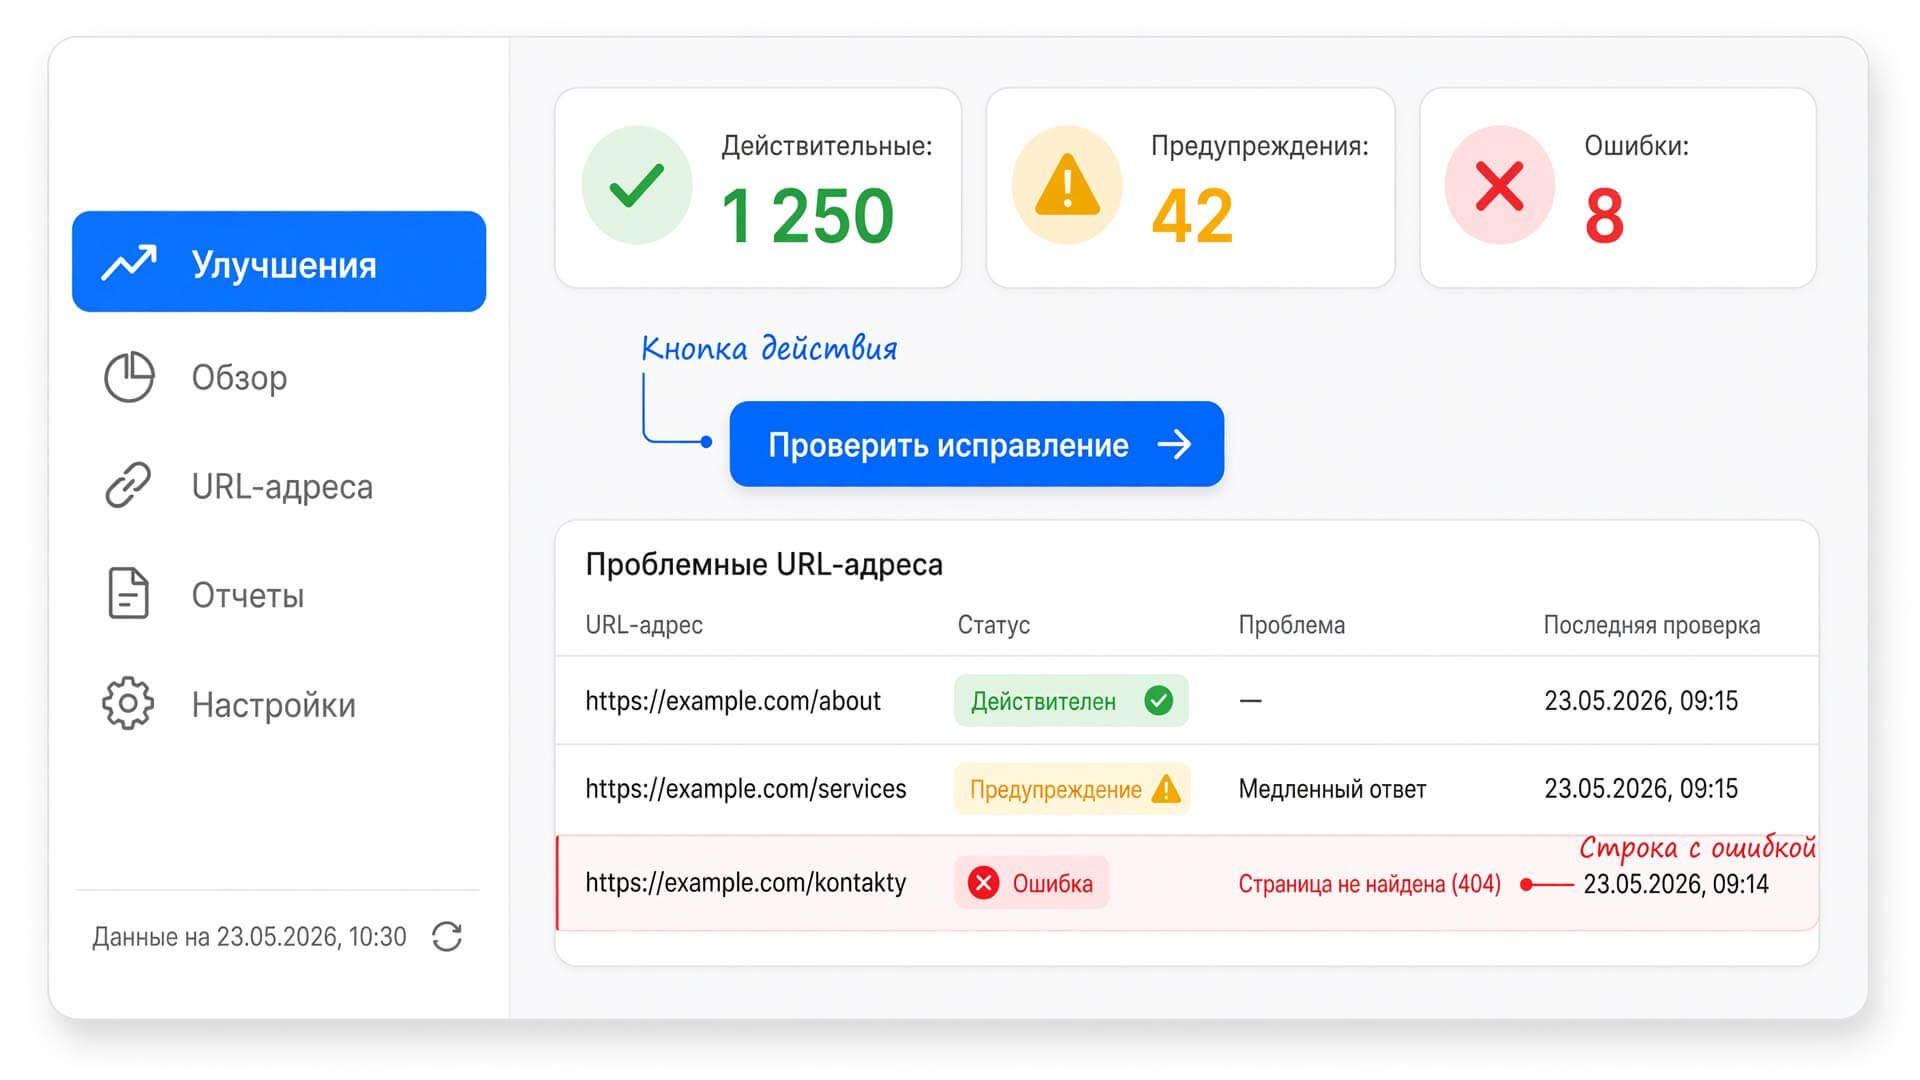
После успешного прохождения тестов и публикации страницы на боевом сервере контроль переходит в панель для веб-мастеров. В Google Search Console предусмотрен специальный раздел «Улучшения» (Enhancements). Система автоматически группирует найденные на сайте структурированные данные по типам (товары, строки навигации, окна поиска) и строит графики их статуса.
Отчеты в консоли делятся на две категории проблем. Статус «Предупреждение» (Warning) сигнализирует о том, что код валиден, но в нем отсутствуют рекомендуемые (необязательные) поля. Страница с предупреждением может получать расширенный сниппет, но его информативность будет снижена. Статус «Ошибка» (Error) означает критический сбой: отсутствие обязательного поля или нарушение синтаксиса. Страницы с ошибками полностью исключаются из программы расширенных результатов.
Процесс отладки через консоль выглядит так: инженер открывает отчет с ошибками, изучает список проблемных URL, выявляет закономерность (например, сбой в шаблоне CMS), вносит исправления в код сайта, а затем нажимает кнопку «Проверить исправление» в интерфейсе консоли. Это инициирует приоритетный переобход проблемных страниц краулером.
Частая проблема при работе с Search Console — длительное ожидание смены статуса после исправления кода. Веб-мастер устранил ошибку, нажал кнопку проверки, но график не меняется неделями. Это связано с квотами на краулинг. Чтобы ускорить процесс, прогоните несколько ключевых исправленных URL через инструмент «Проверка URL» и запросите индексацию вручную. Это форсирует обновление кэша.
Частые ошибки структурирования
Анализ сотен технических аудитов показывает, что большинство проблем с машиночитаемым кодом носит типовой характер. Избежать потери трафика можно, исключив пять наиболее распространенных паттернов ошибок на этапе проектирования архитектуры данных.
Первая и самая критичная ошибка — разметка скрытого контента. Технология создана для описания того, что видит пользователь. Если в JSON-LD передается массив из пятидесяти отзывов с пятизвездочным рейтингом, а на визуальной странице нет ни одного комментария, алгоритмы классифицируют это как спам. Наказанием служат ручные санкции и полное отключение расширенных сниппетов для домена.
Вторая проблема — игнорирование обязательных свойств. Каждая коммерческая сущность имеет жесткий каркас. Для товара это цена и валюта. Попытка разметить карточку продукта без указания стоимости приведет к фатальной ошибке парсинга. Поисковик не станет выводить сниппет с пустым полем цены, он просто проигнорирует весь блок данных.
Третья ошибка связана с синтаксисом JSON. Формат крайне чувствителен к пунктуации. Оставленная запятая после последнего элемента массива (trailing comma), использование одинарных кавычек вместо двойных для ключей, незакрытые фигурные скобки — любая из этих оплошностей ломает парсер. Браузер может проигнорировать ошибку в JS, но строгий валидатор поисковика отвергнет невалидный код.
Четвертая аномалия — семантическое несоответствие. Разработчики иногда пытаются использовать неподходящие типы для получения красивого сниппета. Например, размечают страницу услуги по ремонту квартир как кулинарный рецепт, чтобы получить миниатюру картинки в выдаче. Подобные манипуляции быстро вычисляются нейросетевыми фильтрами, анализирующими текстовый контекст страницы.
Пятая проблема — фрагментация данных без связывания. На странице может присутствовать несколько блоков JSON-LD: один описывает организацию, другой — статью, третий — автора. Если они не связаны между собой через идентификаторы @id, поисковик видит набор разрозненных фактов. Правильная архитектура подразумевает вложенность или явное связывание сущностей в единый граф.
Заметка
Регулярный технический аудит машиночитаемого кода должен проводиться после каждого мажорного обновления CMS или смены дизайна сайта. Изменение структуры базы данных или переименование переменных в шаблонах верстки часто приводит к тому, что скрипты начинают генерировать пустые значения или отдавать ошибки синтаксиса.
Технический глоссарий терминов
Сниппет — информационный блок, представляющий веб-страницу в результатах поисковой выдачи; расширенная версия включает дополнительные визуальные элементы, извлеченные из структурированных данных.
JSON-LD — текстовый формат обмена данными, основанный на синтаксисе JavaScript Object Notation, предназначенный для внедрения связанных данных в веб-документы без вмешательства в визуальную HTML-верстку.
Парсинг — процесс автоматического синтаксического анализа исходного кода страницы поисковым роботом с целью извлечения, проверки и структурирования полезной информации по заданным алгоритмам.
Валидация — процедура автоматизированной проверки машиночитаемого кода на предмет отсутствия синтаксических ошибок и строгого соответствия спецификациям семантических словарей.
Часто задаваемые вопросы
Влияет ли микроразметка Schema.org напрямую на позиции сайта?
Нет, технология не является прямым фактором ранжирования алгоритмов. Наличие валидного кода не гарантирует повышения позиций в выдаче. Основная функция словарей — предоставление поисковым системам структурированной информации для формирования расширенных сниппетов. Именно привлекательный внешний вид сниппета увеличивает кликабельность (CTR), что в свою очередь генерирует положительные поведенческие сигналы, косвенно влияющие на рост позиций.
Можно ли комбинировать JSON-LD и Microdata на одной странице?
Технически спецификации допускают присутствие нескольких форматов в одном документе, однако на практике это категорически не рекомендуется. Дублирование сущностей в разных синтаксисах перегружает код, увеличивает размер DOM-дерева и создает высокий риск конфликта данных. Если значения в скрипте и атрибутах тегов разойдутся, парсер может проигнорировать оба блока. Оптимальное решение — полный переход на изолированные скрипты.
Нужно ли размечать каждую страницу на сайте?
Сплошное структурирование всего пула URL-адресов нецелесообразно. Обрабатывать следует исключительно те документы, которые содержат значимые для бизнеса и поиска сущности: карточки товаров, информационные статьи, страницы услуг, контактные данные, списки вопросов и ответов. Технические страницы, такие как политика конфиденциальности, пользовательское соглашение или корзина покупателя, не нуждаются в семантическом описании, так как не участвуют в формировании расширенных результатов.
Какой синтаксис микроразметки рекомендует Google в 2026 году?
В 2026 году абсолютным приоритетом и официальной рекомендацией поисковых систем остается формат JSON-LD. Его использование минимизирует риск поломки верстки, упрощает поддержку кода и снижает нагрузку на браузер при рендеринге страницы. Альтернативные форматы сохраняют поддержку для обеспечения совместимости со старыми ресурсами, но для новых разработок и редизайнов их применение считается технически устаревшим подходом.
Что делать, если Google Rich Results Test показывает ошибки?
Процесс отладки начинается с проверки синтаксиса: необходимо исключить лишние запятые, проверить парность кавычек и скобок. Далее следует сверить код со спецификацией проблемного типа, убедившись в наличии всех обязательных свойств (например, цены для товара). После внесения правок в исходный код страница повторно прогоняется через валидатор. При успешном прохождении теста исправленный URL отправляется на принудительное пересканирование через панель веб-мастера.
Выводы
Внедрение семантических словарей представляет собой обязательный этап технической оптимизации современного веб-ресурса. Перевод визуального контента в строгий машиночитаемый формат устраняет двусмысленность при сканировании страниц поисковыми роботами. Алгоритмы получают доступ к чистым, структурированным фактам, что позволяет им формировать максимально релевантные и визуально привлекательные ответы на запросы пользователей.
Успешная интеграция технологии базируется на соблюдении строгих правил. Выбор формата однозначен — изолированные скрипты обеспечивают безопасность верстки и высокую скорость обработки. Соответствие скрытого кода видимому контенту является непреложным законом, нарушение которого ведет к санкциям. Использование базовых онтологий закрывает потребности большинства коммерческих проектов, а регулярная валидация гарантирует стабильное отображение расширенных результатов.
Работа со структурированными данными не существует в вакууме. Она является логичным продолжением комплексной стратегии развития проекта. Сначала собирается и кластеризуется семантическое ядро сайта, затем проектируется архитектура, создается контент, и только потом этот контент формализуется для алгоритмов. Понимание этих взаимосвязей — ключевой навык, которым должен обладать квалифицированный SEO-специалист, проектирующий системы, устойчивые к изменениям поисковых алгоритмов.
Комментарии
Комментариев пока нет. Будьте первым!