Что такое rel canonical и каноническая страница
Когда один контент открывается по нескольким адресам, поисковику нужно выбрать один из них. Rel canonical — атрибут rel элемента link, который в разделе head указывает поисковым системам основную каноническую страницу среди одинаковых или очень похожих. Его же называют link rel canonical, тег rel canonical, канонический тег, тег canonical или каноникал.
Страница, на которую ведёт тег, называется канонической. Страница, где тег указывает на другой адрес, считается неканонической: это вариант страницы с тегом canonical. Так вы сообщаете роботу, какой адрес показывать в поиске. Именно такие страницы поисковик, как правило, и показывает в выдаче.
Поисковик может выбрать другой URL, если сигналы расходятся. Google делает это даже при явном указании: выбор зависит от качества контента и технических сигналов. Яндекс в ряде случаев тоже может проигнорировать указание.
Если канонический URL не указан, Google сам определяет подходящую версию. Как правило, указывать каноническую ссылку не требуется, но причин сделать это немало.
Минимальный пример выглядит так. Тег занимает одну строку:
<link rel="canonical" href="https://example.com/catalog/shirt/">Если поставить его на странице https://example.com/catalog/shirt/?sort=price, он сообщит поисковикам: основной адрес — без параметра сортировки.
Зачем нужен canonical в SEO
Canonical помогает выбрать адрес для выдачи и собрать сигналы на одной странице. Google называет четыре причины его указывать:
- Выбор адреса. В поиске показывается нужный URL, а не случайная копия.
- Группировка сигналов. Внешние ссылки на варианты адреса, например на версию с меткой ?gclid=ABCD, объединяются со ссылками на канонический URL. Ссылочный вес меньше распыляется между копиями.
- Единая статистика. Данные по контенту собираются на одном адресе, и отчёты по странице читаются проще.
- Экономия сканирования. Робот тратит меньше времени на копии.
Яндекс работает по похожей схеме. При дублях робот объединяет страницы в группу дублей и показывает из неё одну — наиболее информативную. Предпочтительную страницу можно указать через rel canonical. Если указание корректно и робот его не проигнорировал, неканоническая страница после обхода пропадёт из результатов поиска. Так Яндекс учитывает тег canonical: как рекомендацию, которую робот проверяет по контенту.
Рост позиций canonical не гарантирует. Он наводит порядок среди копий и позиции сам не поднимает.
Индексацию он тоже не закрывает: для этого есть другие инструменты.
Когда страницам нужен канонический URL
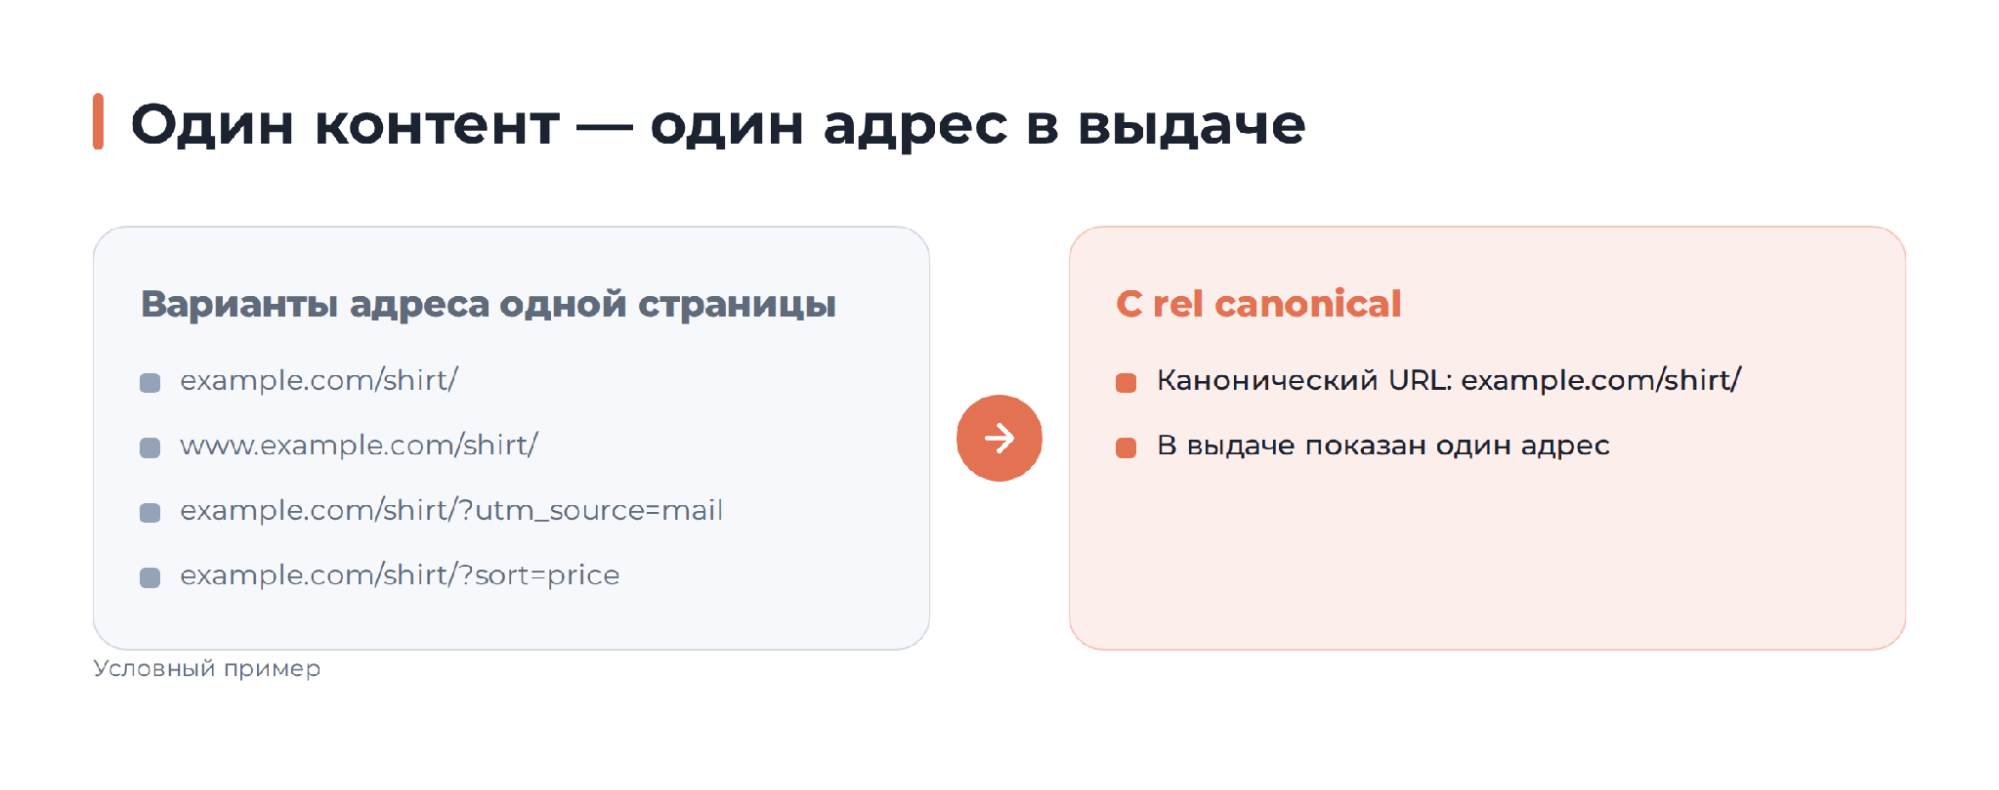
Canonical нужен там, где один контент открывается по нескольким адресам и все они остаются доступными.
Типовые сценарии дублей
| Сценарий | Пример адресов |
|---|---|
| Версии адреса | http://example.com/ и https://www.example.com/ |
| Слеш и регистр | /shirt и /shirt/, /Shirt |
| Метки | ?utm_source=mail, ?gclid=ABCD |
| Сортировка и фильтры | ?sort=price, ?color=red |
| Товар в разных категориях | /men/shirt/ и /sale/shirt/ |
| PDF и HTML | page.pdf с тем же текстом, что и page.html |
Чаще всего дубли создают адреса с параметрами. Параметры сортировки и фильтрации, метки и номера сессий порождают десятки вариантов одной страницы, и каждый открывается как самостоятельный URL. Похожая картина у товара в нескольких категориях: контент один, а путей к нему несколько.
С метками проще всего понять масштаб: сколько рекламных ссылок, столько адресов у одной страницы. Внешние ссылки при этом приходят на разные варианты адреса, и без canonical их сигналы могут делиться между копиями.
Версии адреса — http и https, с www и без, со слешем и без, в верхнем и нижнем регистре — выглядят для пользователя одной страницей. Для робота это отдельные URL, пока вы не указали основной.
Отдельный случай — копии документов, когда PDF повторяет содержимое HTML-страницы.
Где canonical не работает
Google игнорирует canonical, который указывает на альтернативную версию страницы, а аннотации с атрибутами hreflang, lang, media и type не использует для нормализации. Чтобы связать языковые версии, нужен link rel alternate с атрибутом hreflang, а для мобильной версии с отдельным адресом на основной странице ставят rel alternate с атрибутом media.
Страницы с разным содержимым и интентом тоже не склеиваются: canonical выбирает версию среди одинаковых страниц, а не объединяет разные по смыслу. Если на странице-копии контент заметно отличается, Яндекс может не учесть указание.
Стоит запомнить
Canonical отвечает на вопрос «какая из одинаковых страниц основная». Если страницы отвечают на разные запросы, им нужны отдельные адреса и собственное содержимое, а не общий канонический URL.
Как указать canonical четырьмя способами
Способов четыре: тег в head, HTTP-заголовок, файл sitemap.xml и настройки CMS. Основной — тег link, а выбор зависит от типа файла и доступа к серверу.
Тег link в head
Это классический вариант: элемент link с атрибутом rel canonical и адресом в href. Google принимает его только в разделе head, поэтому HTML в head должен быть корректным. На странице нужен один тег. В head он стоит рядом с тегом Title и метатегом Description:
<head> <title>Рубашка мужская</title> <link rel="canonical" href="https://example.com/catalog/shirt/"> </head>Адрес в href пишите полностью, с протоколом: link rel canonical href https://example.com/... Google допускает относительные пути, но не рекомендует. Яндекс требует абсолютный путь в пределах одного домена.
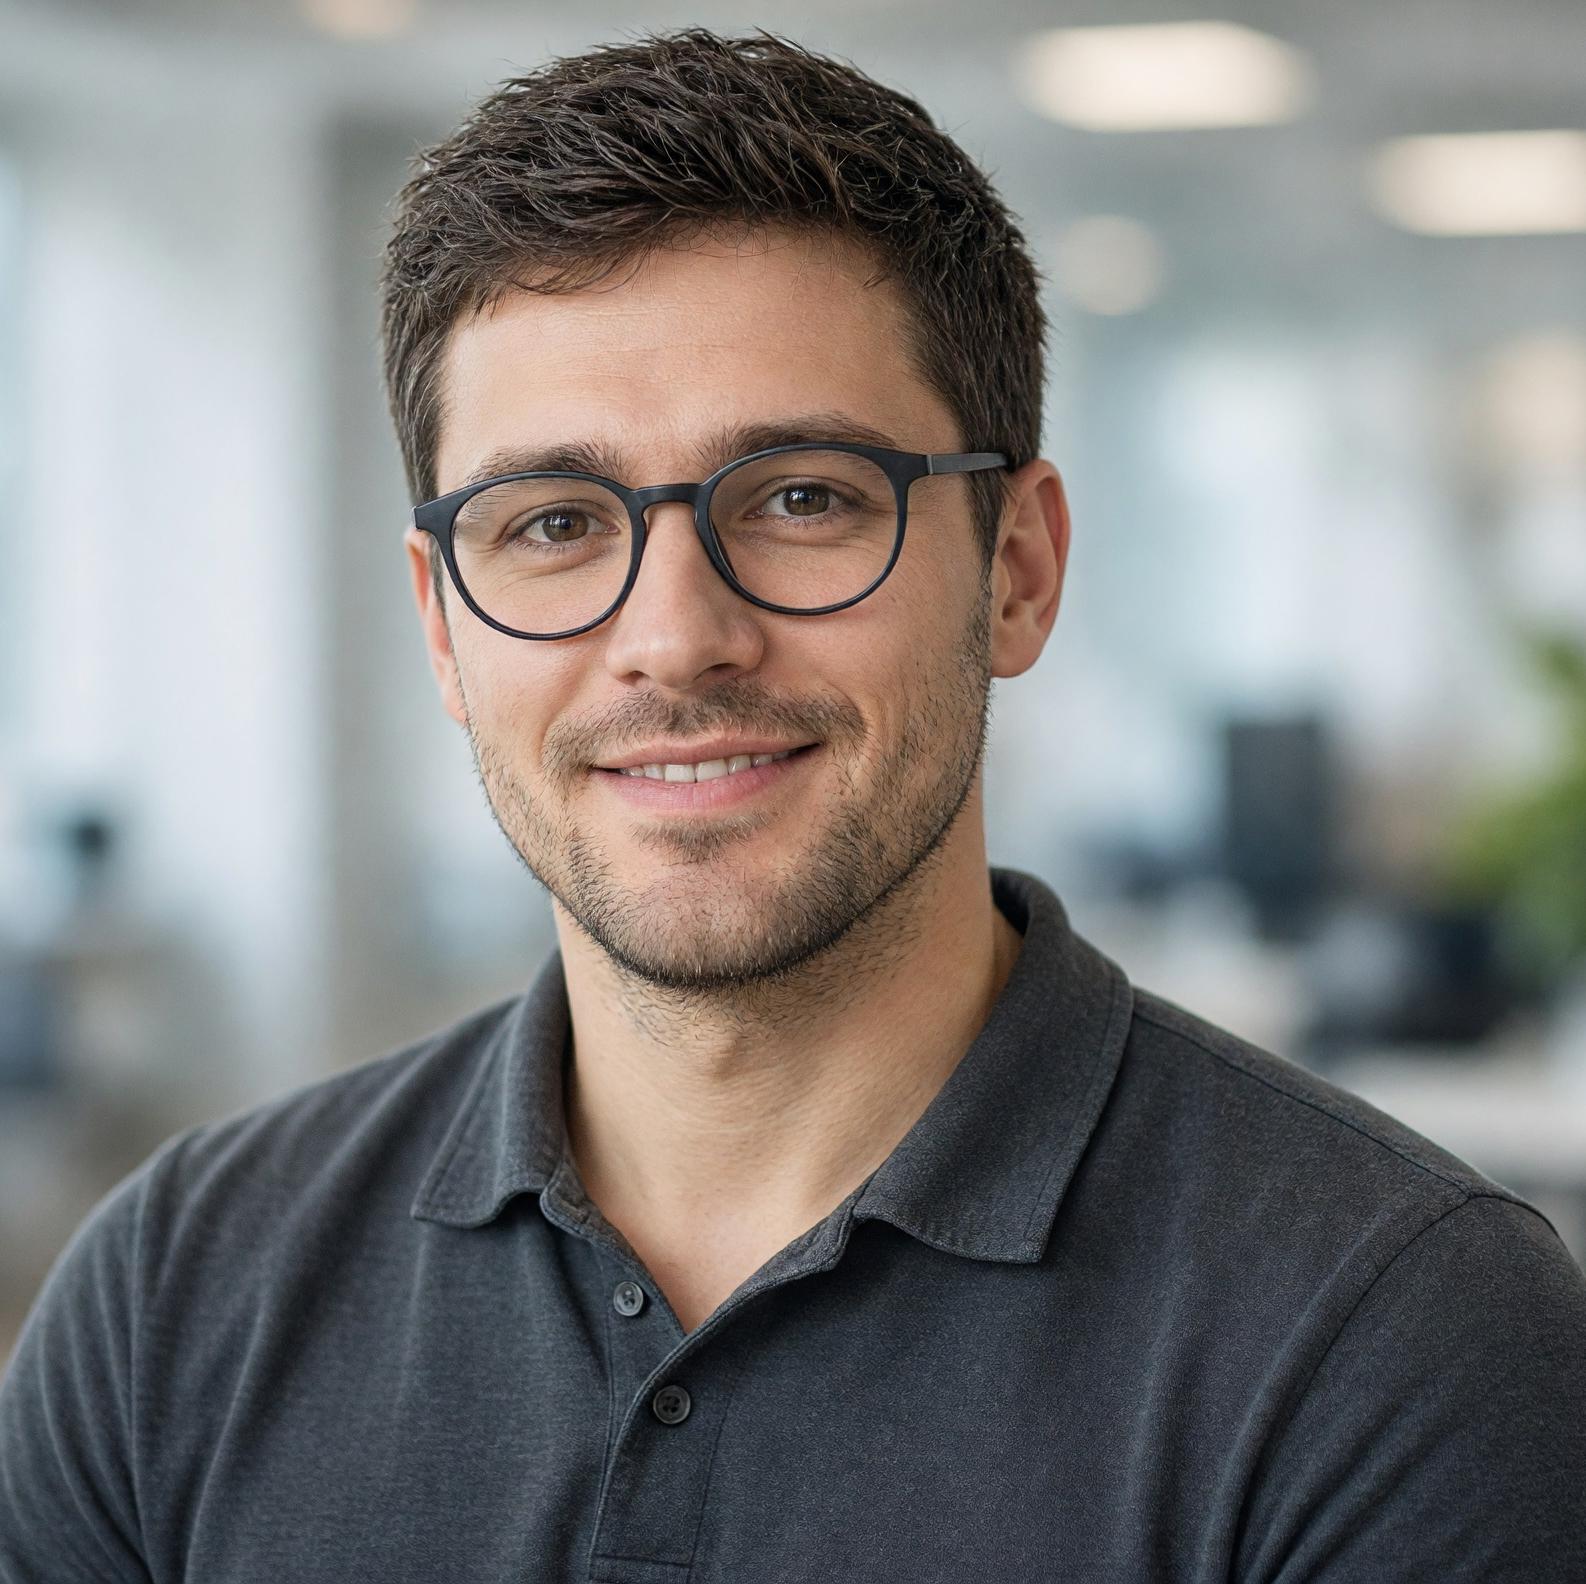
HTTP-заголовок для PDF и других файлов
Для файлов не в формате HTML, например PDF, тег в head поставить негде. Здесь работает HTTP-заголовок Link с rel canonical. Для него нужен доступ к настройкам сервера, а адрес снова указывают полностью. Google поддерживает этот способ только для веб-поиска. В ответе сервера для файла https://example.com/files/shirt.pdf заголовок выглядит так:
Link: <https://example.com/catalog/shirt/>; rel="canonical"Sitemap и CMS
Все адреса в файле sitemap.xml Google воспринимает как предлагаемые канонические страницы. Поэтому в sitemap и в теге canonical должен стоять один и тот же адрес. Для больших сайтов это проще, чем размечать каждую страницу, но сигнал слабее: Google относит sitemap к менее эффективным способам.
Системы управления сайтом и плагины добавляют тег без правки шаблонов. Итоговый HTML страницы нужно открыть и проверить: плагин мог вывести другой адрес.
У тега есть сильная сторона: он позволяет пометить любое количество страниц. Есть и слабая: на крупных сайтах и там, где URL часто меняется, разметка требует много усилий. К тому же тег работает только с HTML-страницами, поэтому для файлов нужен заголовок. Google перечисляет способы по убыванию эффективности так: редирект, rel canonical, sitemap.
Способы можно сочетать: так выше вероятность, что поисковик выберет нужный URL. Разные адреса в разных способах указывать нельзя. Совпадение адресов везде — главное условие.
Вырастили трафик c 200 переходов до 90 тыс. в месяц.
Читать кейс
Canonical и страницы пагинации
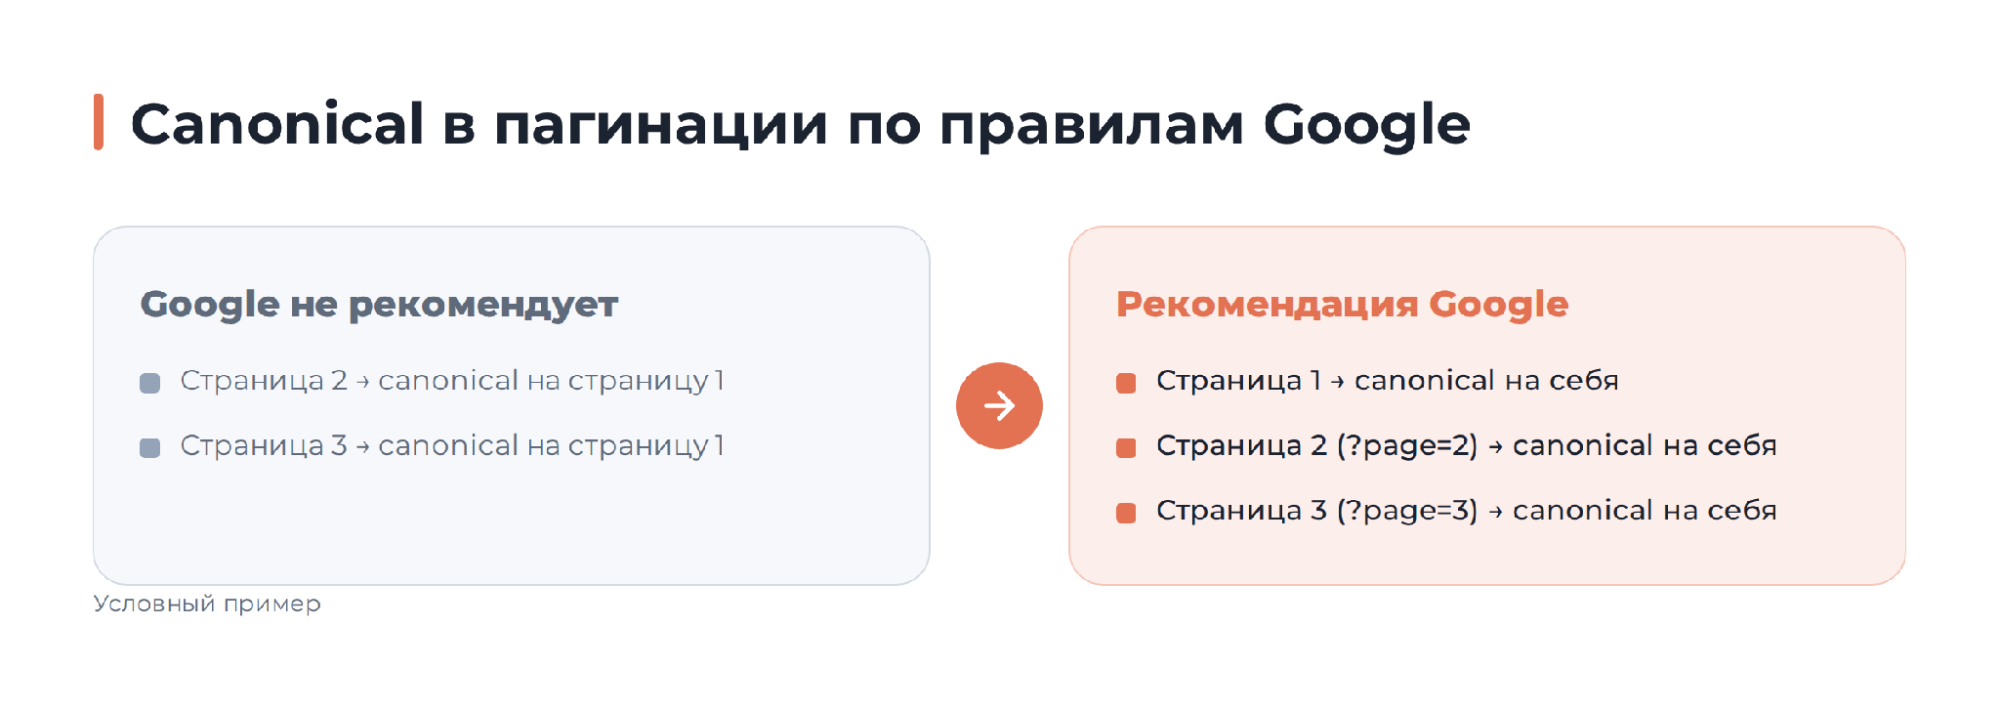
Google советует давать каждой странице пагинации свой канонический URL: например, ?page=2 указывает сам на себя. У каждой страницы при этом должен быть уникальный адрес вида ?page=n.
Первую страницу Google не советует делать канонической для остальных.
Причина простая: на страницах 2 и 3 лежат другие товары или записи, это не копии первой. Тег на первую страницу сообщил бы поисковику, что весь листинг — её дубли.
У Яндекса подход мягче. Если на страницы 2, 3 и дальше нет трафика из поиска и их контент во многом повторяет первую, Яндекс советует указать канонической первую страницу каталога: в выдаче останется она, а ссылки на товары со следующих страниц робот всё равно увидит.
Что учитывает Яндекс, а что Google
Общего у систем больше, чем разного, но часть правил нельзя переносить из одной в другую. Общее: обе поисковые системы воспринимают canonical как рекомендацию и выбирают версию по совокупности сигналов.
Когда Яндекс не учитывает canonical
В справке Яндекса перечислено пять случаев, когда канонический адрес не учитывается:
- неканонические страницы на момент обхода полнее отвечают на запрос, а их контент существенно отличается;
- канонический адрес недоступен: на нём редирект или он закрыт от индексирования;
- указан адрес другого домена или поддомена;
- на странице несколько канонических адресов;
- указана цепочка канонических адресов.
HTTPS и www
При переезде с HTTP на HTTPS Яндекс просит настроить редирект 301 или 302. Rel canonical для адресов такого формата больше не поддерживается.
Со сменой www на адрес без www и обратно мягче: canonical допустим, робот воспримет его как редирект на новый главный адрес. Надёжнее всё равно редирект 301 или 302.
Для справки
Для переезда на www или без www через canonical тег должен стоять на каждой странице старого сайта и вести на аналогичную страницу нового. Если он указывает на другую страницу, робот может счесть это различием в структуре сайтов и переезд будет невозможен.
Параметры и метки
Чтобы исключить из поиска неканоническую страницу с GET-параметрами или метками, Яндекс советует директиву Clean-param в robots.txt, а в других случаях Disallow. Google рекомендует обратное: для нормализации ни robots.txt, ни инструмент удаления URL использовать не стоит.
Как Google выбирает канонический URL
Google смотрит на несколько сигналов. Редирект и rel canonical он называет явными признаками основного URL, sitemap — менее сильным сигналом. Если проблем нет, HTTPS предпочтительнее HTTP. Сигналы Google имеют разный вес, поэтому конфликт между ними размывает выбор.
Внутренние ссылки лучше вести на канонические URL: это ещё один сигнал в ту же сторону.
Почему Google выбирает не тот адрес
Если выбранный Google URL отличается от желаемого, причину ищут в нескольких местах. Языковые варианты страницы могут быть без локализованных аннотаций. CMS или плагин могут неверно выполнять нормализацию и указывать на нежелательные адреса. Бывают ошибки в настройках сервера. Наконец, Google может счесть страницу скопированным контентом.
Что делать: открыть итоговый код проблемной страницы и сравнить указанный адрес с тем, который выбрал Google.
| Вопрос | Яндекс | |
|---|---|---|
| Как учитывает тег | Рекомендация, может проигнорировать | Явный признак, но выбор может быть иным |
| Переезд на HTTPS | Только редирект 301 или 302 | HTTPS предпочтительнее, если нет проблем |
| Параметры и метки | Clean-param или Disallow в robots.txt | robots.txt для нормализации не нужен |
| Файлы не в HTML | HTTP-заголовок Link | HTTP-заголовок, только для веб-поиска |
Вывод простой: настройку проверяют в обеих системах отдельно.
Canonical, редирект 301, noindex и robots.txt
Метод выбирают по судьбе старых адресов: нужны ли они пользователям.
Редирект 301 подходит, когда старый адрес больше не нужен. Google называет редирект явным признаком основного URL, а для переезда на HTTPS в Яндексе он обязателен.
Canonical нужен, когда несколько адресов остаются доступными, например страницы с сортировкой.
Noindex для выбора канонической страницы Google не рекомендует. Он приведёт к полной блокировке страницы в поиске, а не к замене копии основной версией.
С robots.txt похожая ловушка. Google может индексировать URL, запрещённые в robots.txt, но без их содержимого. Инструмент удаления URL тоже не подходит: он скрывает из результатов поиска все варианты адреса, а не только копии. Для Яндекса с метками и параметрами работает Clean-param.
| Метод | Когда подходит | Ограничение |
|---|---|---|
| Редирект 301 | Старый адрес не нужен | Старый адрес перестаёт открываться |
| Rel canonical | Несколько адресов остаются доступными | Рекомендация, не команда |
| Noindex | Страницу нужно убрать из поиска | Не способ выбрать каноническую |
| Robots.txt | Закрыть обход адресов в Яндексе | Для нормализации в Google не нужен |
| Clean-param | Метки и параметры в Яндексе | Директива только для Яндекса |
Отдельное условие: sitemap, внутренние ссылки и canonical должны вести на один адрес. Конфликт сигналов размывает выбор.
Проверим сайт по 100+ параметрам. Проанализируем все, что влияет на продвижение в поиске.
Обсудить проект
Частые ошибки при настройке canonical
Большинство ошибок сводится к конфликту сигналов или неверному месту тега:
- Тег вне head. Google принимает его только в разделе head.
- Несколько адресов. Если на странице несколько канонических адресов, Яндекс не учтёт ни один.
- Разные адреса в теге, заголовке и sitemap. Поисковик получает противоречивые сигналы.
- Цепочка канонических адресов. Яндекс такую цепочку не учитывает.
- Canonical на закрытую или редиректящую страницу. В Яндексе указание не сработает.
- Относительные URL. Google их не рекомендует, а Яндекс требует абсолютный путь.
- Другой домен или поддомен. Яндекс такой адрес не учитывает.
- Первая страница пагинации как canonical для всех в Google. Google советует давать каждой странице собственный канонический адрес.
Внутренние ссылки — отдельный источник конфликта. Если меню и карточки ведут на неканонические адреса, а в canonical указан другой, поисковик получает два разных сигнала. Ссылки должны вести на тот же URL, что указан в теге.
Отдельная ловушка — массовые настройки по шаблону. Если шаблон или плагин прописывает canonical на главную для всех страниц, разделы и карточки заявляют главную основной версией, хотя контент у них разный. Откройте итоговый код страниц разных типов: раздела, карточки, статьи.

Как проверить canonical и найти дубли
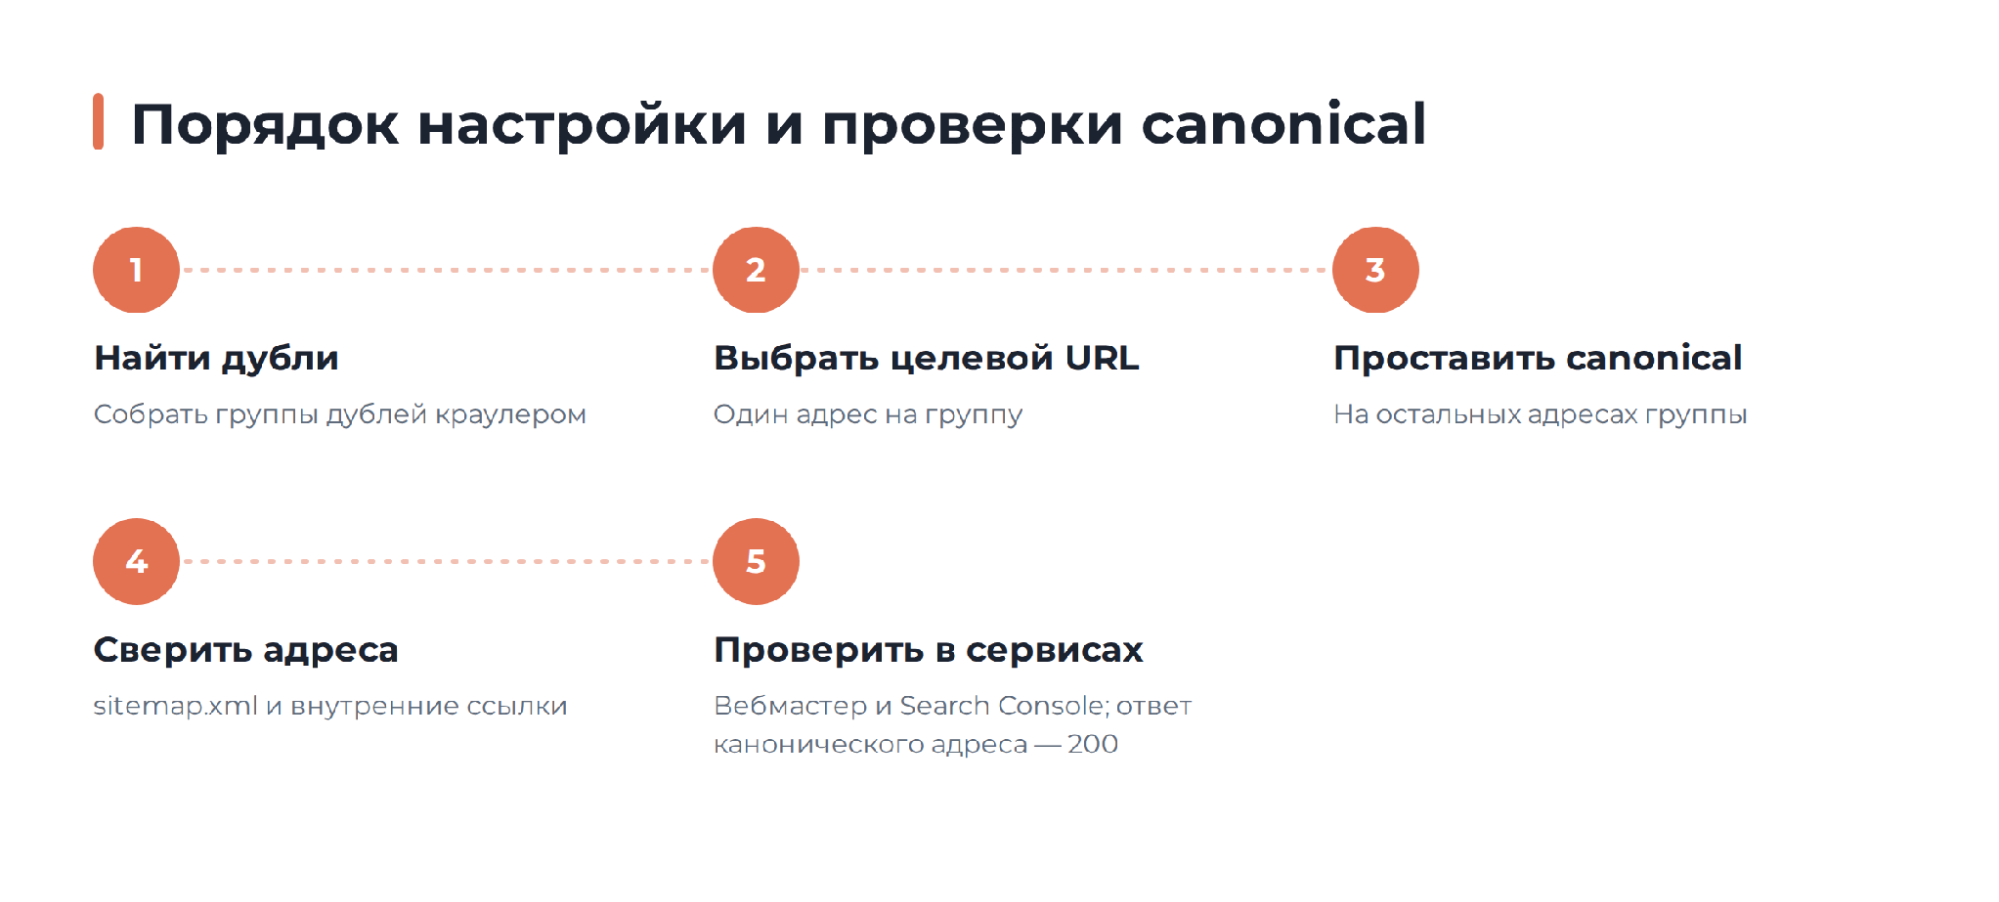
Проверка идёт от поиска дублей до сверки в «Яндекс Вебмастере» и Google Search Console. Порядок ниже — методика агентства:
- Соберите краулером группы адресов с одним и тем же содержимым.
- Для каждой группы выберите целевой URL.
- Проставьте canonical на остальных адресах группы.
- Сверьте адрес с sitemap.xml и внутренними ссылками.
- Проверьте результат в «Яндекс Вебмастере» и Search Console.
Что смотреть в коде и заголовках
В коде проверяют несколько вещей. Тег один и стоит в head, адрес в нём абсолютный, он совпадает с адресом в sitemap, а страница по этому адресу отвечает кодом 200.
Ответ сервера смотрят отдельно от HTML: заголовки Link для файлов в коде страницы не видны.
Где проверять результат
Результат проверяют в сервисах поисковиков. В Google Search Console инструмент проверки URL показывает, какую страницу Google считает канонической. Для Яндекса есть «Яндекс Вебмастер»: там видно, какие страницы исключены как дубли или как неканонические. Неканоническая страница со временем уходит из поиска.
В справке Яндекса среди причин исключения страниц названы следующие: «Страница дублирует содержание другой страницы» и «Страница не является канонической». Во втором случае проверьте, что страница действительно должна направлять робота на адрес из rel canonical.
Важно
Проверка опубликованной страницы в Search Console не показывает, является ли она канонической или копией. Выбранный Google канонический URL смотрят в данных об индексированной версии страницы.
Если разбираться самим некогда, проверку можно доверить техническому аудиту сайта: дубли редко живут по одному, массовые случаи видны только на полном обходе.
Частые вопросы о rel canonical
Нужен ли canonical на каждой странице?
Google рекомендует ставить на каноническую страницу самоссылающийся canonical, то есть ссылку на саму себя. Для Яндекса такой тег тоже работает: если canonical указывает на эту же страницу, робот считает её канонической.
Поэтому для уникальных страниц самоссылка уместна.
Что делать, если страница пропала из поиска как неканоническая?
В Яндексе страница исключается как неканоническая, когда робот нашёл в её HTML или HTTP-заголовке rel canonical на другой адрес. Удалите это указание и убедитесь, что индексирование страницы не запрещено.
Как быстро Google пересмотрит страницу после исправлений?
Если страницу считали копией из-за близкого контента, между страницами нужны достаточные отличия. После исправления контента Google может ещё до двух недель удерживать страницы в кластере копий.
Повторную оценку можно запросить функцией «Запросить индексирование» в инструменте проверки URL: на неё действуют квоты.
Главное о rel canonical
Canonical — это рекомендация поисковику об основной версии страницы. Ставьте его там, где адресов несколько:
- Rel canonical — атрибут link в head, а не команда: поисковик может выбрать другой URL.
- Тег нужен там, где один контент открывается по нескольким адресам: метки, сортировка, версии адреса, копии файлов.
- Для Google у каждой страницы пагинации свой канонический адрес, а Яндекс допускает canonical на первую страницу, если остальные не приносят трафика и во многом её повторяют.
- Яндекс и Google учитывают тег по-разному: параметры, HTTPS и www решают разными инструментами.
- Для переезда с HTTP на HTTPS в Яндексе нужен редирект 301 или 302.
- Код, sitemap.xml, внутренние ссылки и ответ сервера проверяйте вместе: конфликт между ними размывает выбор.
Начните с группы дублей и выберите метод под каждую: редирект, canonical или, для меток и параметров в Яндексе, Clean-param в robots.txt. Если дублей много и они разных типов, такую работу удобнее вести в рамках SEO-продвижения сайта, где техническая оптимизация идёт вместе с остальными задачами.
Плати только за фактически достигнутый результат.
Наша цель: лиды, позиции и трафик
Комментарии
Комментариев пока нет. Будьте первым!