Что такое кластеризация семантического ядра и зачем она нужна
Фундаментальный процесс SEO-оптимизации начинается с базовых понятий. Кластеризация семантического ядра — это аналитический процесс объединения схожих по смыслу и пользовательскому интенту поисковых фраз в логические группы (кластеры) для их последующего распределения по релевантным страницам сайта. Каждая сформированная группа должна исчерпывающе покрывать одну информационную или коммерческую потребность аудитории.
Разбираясь, что такое кластеризация запросов, необходимо отказаться от устаревшего подхода простого подбора синонимов. Грамотная группировка семантического ядра всегда учитывает реальную выдачу поисковых систем (SERP) и скрытые намерения пользователя. Поисковым алгоритмам значительно проще определять релевантность документа, когда вся собранная семантика структурирована логично. В итоге поисковые фразы работают в синергии, полностью исключая внутреннюю конкуренцию страниц.
В текущих реалиях логика работы с семантикой кардинально сместилась. Если раньше специалисты группировали фразы исключительно по леммам и словоформам, то теперь фокус направлен на интенты, сущности и широкий контекст. Нейросети и гибридные модели на базе архитектуры BERT и GPT анализируют смысловую близость, историческое поведение пользователя, региональность и предпочтительный тип контента. Усиливается роль направления Entity SEO: ранжирование документа все больше зависит от полноты раскрытия сущностей и глубокого покрытия темы, а не от банальной плотности ключевых слов.
Влияние AI-поиска диктует новые правила. Стремительно растет доля zero-click-выдачи и генеративных ответов, поэтому структуру сайта необходимо строить под комплексные ответы искусственного интеллекта, а не под разрозненные ключи. Правильное распределение сущностей по посадочным страницам становится критически важным фактором ранжирования. На практике это означает разметку фраз по сценариям пути клиента (CJM) и объединение выражений с одинаковым смыслом на одном URL-адресе.
Отличие кластеризации от простой группировки по смыслу
Простая смысловая группировка опирается исключительно на субъективную логику человека. Например, фразы «купить диван» и «заказать диван» кажутся идентичными. Однако профессиональная кластеризация семантики на основе SERP и LLM-эмбеддингов опирается на строгий математический анализ выдачи. Если поисковая система показывает совершенно разные типы URL по этим фразам, алгоритм формирует разные кластеры, полностью игнорируя лексическую схожесть.
Лексически близкие фразы регулярно требуют создания разных посадочных страниц, так как за ними стоит разный интент. Анализ поисковой выдачи демонстрирует несколько типичных сценариев, где семантически похожие слова имеют совершенно разное назначение:
- «Купить диван» и «как выбрать диван». Тематика общая, но первый вариант имеет строгий коммерческий и транзакционный интент, требующий вывода категории или карточек товаров. Второй вариант является информационным, пользователю необходима подробная статья-гайд.
- «Купить дрель ударную», «как выбрать дрель для дома» и «почему дрель искрит». Все фразы связаны с одним инструментом. Первый вариант требует каталога, второй нуждается в обзоре-сравнении, а третий носит диагностический характер и требует инструкции по ремонту или страницы сервисного центра.
- «Купить айфон 13» и «айфон 13 характеристики». В первом случае присутствует явный покупательский интент: аудитория ищет лендинг магазина, цены, условия рассрочки и сопутствующие товары. Во втором случае ожидаются сухие спецификации, независимые обзоры и сравнения с другими моделями.
- «Аренда квартиры» и «снять квартиру самому без риелтора». Первый вариант чаще всего коммерческий, ведущий на агрегаторы и каталоги объявлений. Второй сочетает информационный и практический интент, требуя инструкций, чек-листов и шаблонов договоров найма.
Если попытаться оптимизировать одну страницу под все перечисленные сценарии, поисковая система зафиксирует размытие релевантности. Документ не сможет полноценно закрыть ни одну из потребностей, что приведет к пессимизации в выдаче.
Фундаментальное правило
Базовый принцип современной архитектуры сайта звучит так: один кластер интента равен одной посадочной странице. Попытка охватить разные сценарии поведения на одном URL приводит к потере позиций по всем направлениям.
Преимущества кластеризации семантики для SEO и контента
Системные преимущества кластеризации охватывают техническую архитектуру проекта, поведенческие факторы и качество текстового наполнения. Главная польза заключается в предотвращении каннибализации трафика. Это явление возникает, когда несколько страниц одного ресурса конкурируют за одинаковые позиции в выдаче. Поисковый алгоритм не может определить наиболее релевантный документ, из-за чего страницы постоянно меняются местами, теряя стабильный трафик. Подробные методы поиска и устранения подобных проблем описаны в руководстве про каннибализацию запросов в SEO.
Исследования показывают, что хаотичное распределение ключей и попытка охватить все интенты на одной странице напрямую просаживают видимость и кликабельность (CTR). По статистическим данным, у 79,5 % сайтов, оптимизированных под один точный ключ без широкого тематического охвата, позиции в топ-3 стремительно падают, а каждая четвертая страница выпадает за пределы топ-100. Выигрывают исключительно те материалы, которые обеспечивают комплексное покрытие интента.
Экономическая разница между структурированным и хаотичным подходом колоссальна. Около 96,6 % всех кликов пользователей приходится на первую страницу выдачи, при этом первые три позиции забирают примерно 54,4 % трафика. Любое смещение страницы с правильной кластерной архитектурой в топ-3 многократно увеличивает органический трафик и возврат инвестиций (ROI). Системная работа с кластерами и сезонными ключами обеспечивает рост органики на 50–200 % по сравнению с несистемным набором фраз.
- Оптимизация SEO-показателей. Точное попадание в потребность аудитории снижает показатель отказов. Хорошо организованная Silo-структура, основанная на кластерах, связана со снижением bounce rate до 30 % и увеличением глубины просмотра на 25–40 %.
- Идеальная структура сайта. Формируется жесткая иерархия, где каждая категория логически вытекает из семантических групп. Ссылочный вес остается внутри тематического узла, помогая алгоритмам лучше понимать архитектуру ресурса.
- Максимальная релевантность контента. Страница с естественным распределением 15–20 тематических терминов ранжируется значительно лучше, чем текст с многократным повторением одного ключа. Группа факторов релевантности имеет наивысшую значимость при оценке качества документа.
- Экономия бюджета. Происходит фокусировка усилий на продвижении приоритетных страниц без распыления финансовых и временных ресурсов на дублирующие материалы.
Без грамотно сгруппированного ядра любые дальнейшие работы по наращиванию ссылочной массы или написанию текстов теряют свою эффективность. Поисковая система видит, что страница пытается усидеть на всех стульях одновременно, и отказывается ранжировать ее высоко.
Вырастили трафик c 200 переходов до 90 тыс. в месяц.
Читать кейс
Основные методы кластеризации семантического ядра
Методы кластеризации запросов эволюционировали от простых проверок лексических совпадений к глубокому нейросетевому анализу. Выбор конкретного алгоритма определяет всю будущую архитектуру сайта, поэтому специалисту необходимо понимать технические нюансы каждого подхода.
Ручная и автоматическая кластеризация по топам
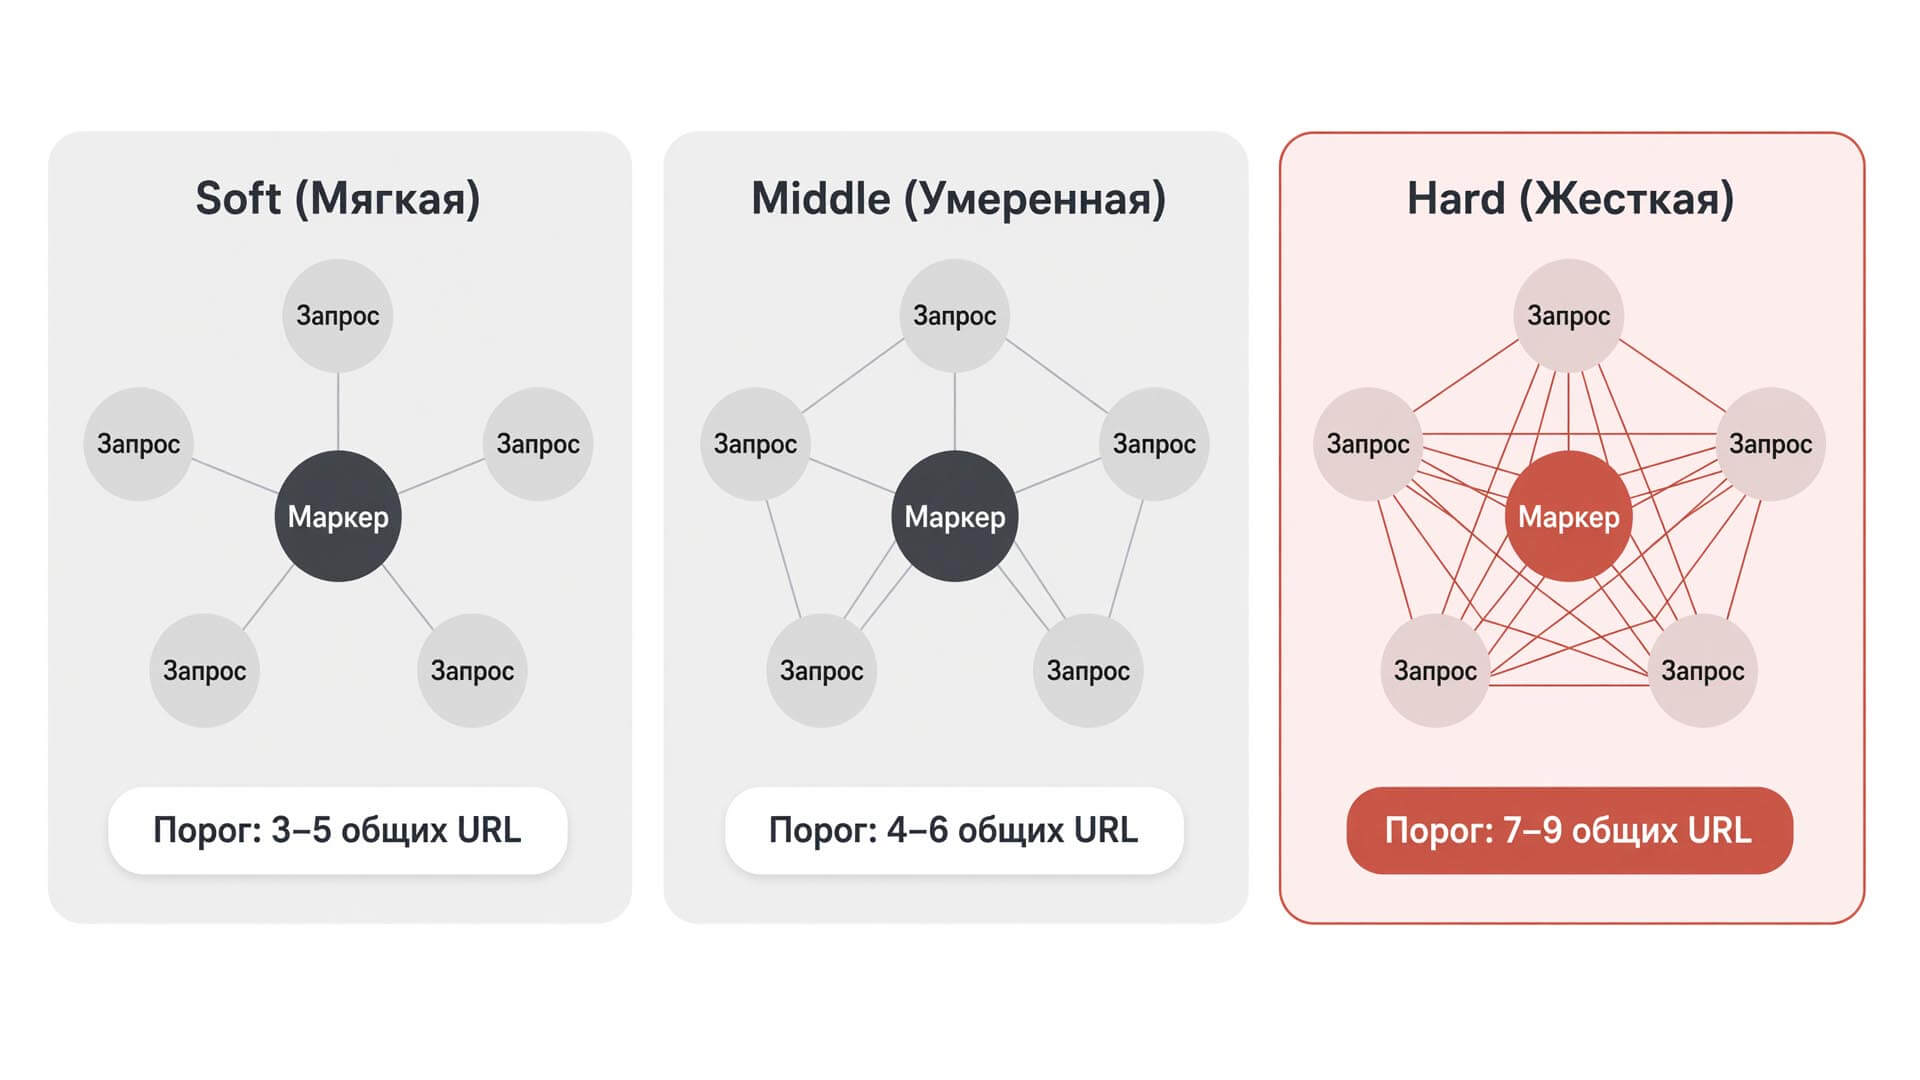
Исторически ручная группировка применялась для небольших пулов ключей, где специалист самостоятельно оценивал логику фраз. Сегодня на рынке доминирует автоматическая кластеризация на основе анализа поисковой выдачи (SERP-overlap). Алгоритмы анализируют топ-10 результатов по двум запросам: если пересечение URL превышает заданный порог, фразы объединяются в одну группу. Степень жесткости этого порога определяет итоговый результат.
- Soft (мягкая). Все фразы кластера связаны с главным маркерным ключом, но могут совершенно не пересекаться между собой. Обычно порог составляет 3–5 общих URL в топ-10. Этот метод идеально подходит для информационных порталов, больших ядер и быстрого старта, но на коммерческих проектах создает слишком размытые группы.
- Middle (умеренная). Фразы сравниваются с маркерным ключом и обязательно должны иметь общее пересечение между собой. Порог составляет 4–6 общих URL. Это компромиссный режим между широтой охвата и точностью, который часто выбирают как универсальный вариант для балансировки структуры.
- Hard (жесткая). Все фразы в группе имеют общие пересекающиеся URL друг с другом. Порог достигает 7–9 общих документов в топ-10. Метод используется для e-commerce, каталогов и узких коммерческих ниш, где критически важна высокая чистота кластера и недопустимо смешивание товарных намерений.
Для справки
Порог совпадения сильно зависит от выбранного инструмента. В разных сервисах его могут задавать как 3, 8 или 12 общих URL. Перед запуском процесса на всем объеме данных обязательно протестируйте настройки на выборке из 5–10 % ядра, чтобы оценить чистоту групп.
ИИ-кластеризация и векторный анализ (LLM)
Современные аналитические инструменты активно используют LLM-эмбеддинги, являющиеся векторнымие представлениями слов. Нейросети переводят запросы в векторы, где математическая близость отражает смысловую похожесть. Затем данные группируются алгоритмами машинного обучения, такими как K-means, DBSCAN или HDBSCAN. Для ускорения обработки огромных массивов часто применяют предварительное кластерирование и поиск по ближайшим центроидам.
Этот подход незаменим при работе с микрочастотными (zero-volume) запросами. Искусственный интеллект анализирует скрытый контекст и предсказывает интент даже там, где статистика выдачи отсутствует. Например, редкие обращения в техническую поддержку вроде «не могу войти» и «забыл код» безошибочно собираются в один кластер для создания шаблонов ответов. Метод Divide & Merge Clustering позволяет выделять тематические группы без заранее заданного числа кластеров, формируя максимально органичные структуры, готовые для генерации контента.
Проверим сайт по 100+ параметрам. Проанализируем все, что влияет на продвижение в поиске.
Обсудить проект
Как сделать кластеризацию запросов: пошаговое руководство
Понимание того, как сделать кластеризацию запросов, является ключевым навыком современного SEO-специалиста. Данная инструкция описывает строгую последовательность действий, актуальную для текущих алгоритмов ранжирования.
Шаг 1. Сбор и очистка семантики
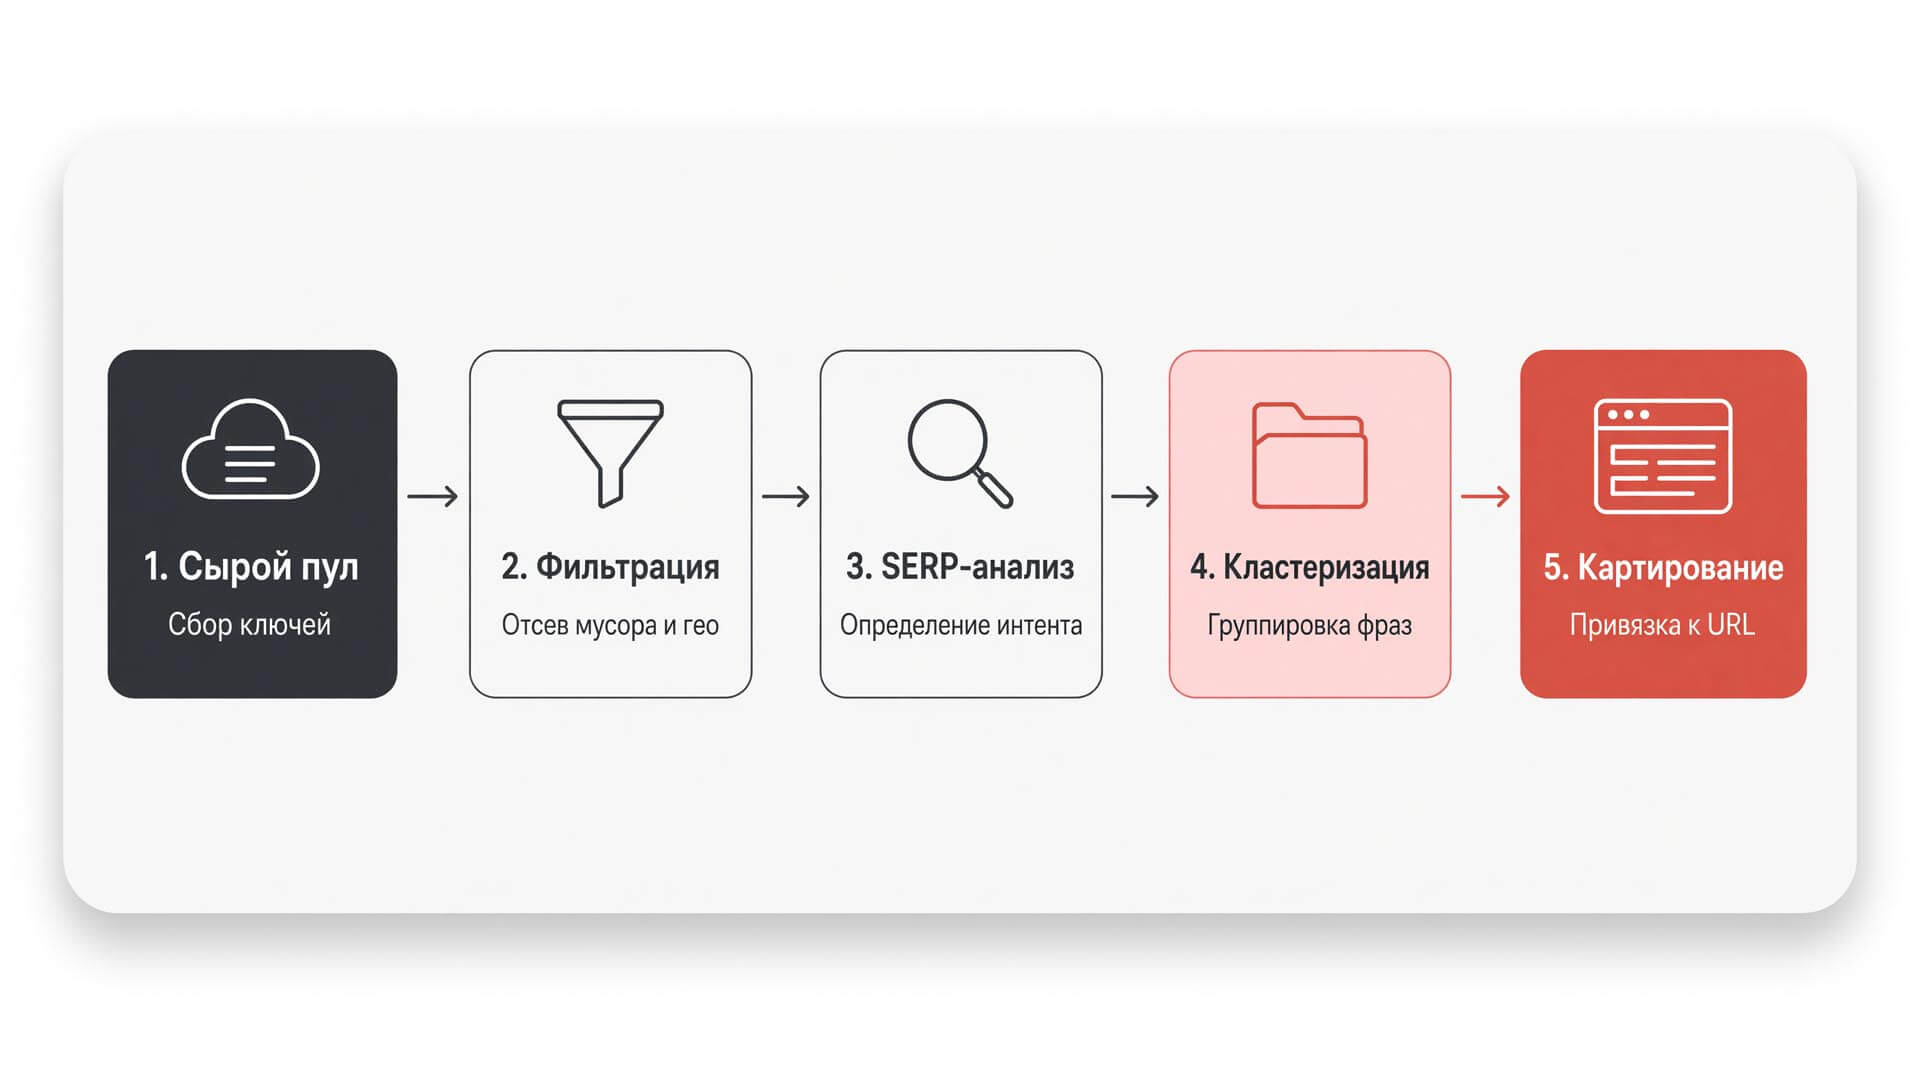
Перед тем как сгруппировать поисковые запросы, необходимо собрать максимально широкую базу данных. Используйте выгрузки из систем аналитики, парсинг конкурентов, поисковые подсказки и базы ключевых слов. На этапе сбора не применяются никакие ограничения. Чем шире исходный пул, тем меньше логических дыр останется в итоговой структуре.
Далее следует критически важный этап нормализации и очистки. Чистота исходных данных напрямую определяет качество машинной обработки. Алгоритм очистки включает следующие действия:
- Выгрузите весь массив данных в табличный редактор. Создайте дополнительные столбцы: частотность, регион, интент и статус модерации.
- Удалите явный технический мусор: фразы с нулевой частотностью по целевому региону, бессмысленные наборы символов, обрывки предложений и полные дубликаты.
- Отфильтруйте лексику прямых конкурентов и чужих брендов. Используйте регулярные выражения и маски, например:
samsung|xiaomi|ozon|wildberries. - Отсеките нерелевантные геозапросы. Задайте строгий список целевых регионов продвижения. Для исключения лишних городов примените маску вида
\b(крым|сочи|самара|уфа|казань|спб)\b, а для отсева иностранного трафика —\b(сша|china|europe|germany)\b. - Удалите фразы с неподходящим интентом. Если проект сугубо коммерческий, исключите информационные маркеры с помощью фильтра
\b(что такое|как выбрать|как сделать|инструкция)\b. Также отсеките любителей бесплатного контента маской\b(бесплатно|скачать|торрент)\b. - Примените пакетную фильтрацию по стоп-словам. Вынесите список минус-слов в отдельный диапазон и автоматически разбейте массив на чистые и мусорные фразы.
- Проведите ручную проверку оставшихся пограничных выражений, уделяя особое внимание низкочастотным хвостам.
Итоговый лист чистой семантики отправляется в сервис машинной обработки. Мусорные и гео-нерелевантные листы необходимо сохранить в отдельном файле для возможного ретроспективного анализа.
Шаг 2. Определение интента и группировка
Загрузите подготовленный список в облачный или десктопный сервис автоматической группировки. Настройте базовые параметры: выберите целевую поисковую систему, укажите регион сканирования и задайте степень жесткости. Для первичного анализа нового проекта рекомендуется использовать метод Middle. Система просканирует выдачу, определит доминирующий тип интента (коммерческий, информационный, смешанный) и разобьет массив на группы.
После машинной обработки обязательна ручная постмодерация. Искусственный интеллект и алгоритмы SERP-overlap могут ошибаться при анализе многозначных терминов (омонимов). Для проверки качества используйте пять критериев:
- Проверка интента. Убедитесь, что в одной группе не оказались фразы с транзакционным и навигационным смыслом одновременно.
- Целостность ответа. Оцените, соответствует ли набор фраз реальной посадочной странице, можно ли дать на них логичный ответ в рамках одного документа.
- Отсутствие шума. Проверьте наличие лишних фраз, связанных с другим продуктом или нецелевым трафиком.
- Оценка объема. Убедитесь, что группа не является слишком раздутой. Десятки разнородных хвостов логичнее вынести в более узкие подкатегории.
- Анализ конкурентов. Проверьте, показывает ли выдача по ключам кластера одни и те же типы страниц (статьи, карточки товаров, листинги).
Шаг 3. SEO-картирование (Keyword Mapping)
Финальный этап работы с готовым ядром — распределение утвержденных кластеров по URL-адресам. Каждой группе назначается конкретная посадочная страница. Часть данных привязывается к уже существующим документам, которые отправляются на доработку контента. Оставшиеся группы выявляют логические дыры в структуре ресурса, под них проектируются новые URL.
На этапе картирования формируется итоговая архитектура сайта. Специалист прописывает метатеги, включая HTML тег Title и Description, а также формирует подробные технические задания для копирайтеров. Для усиления статического веса рекомендуется использовать внутреннюю перелинковку между смежными узлами одной категории, формируя правильную Silo-структуру.
Обзор инструментов для кластеризации семантического ядра
Выбор правильного программного обеспечения автоматизирует рутинные процессы и позволяет обрабатывать сотни тысяч фраз за считаные минуты. Современные инструменты делятся на десктопные программы и облачные SaaS-решения. Они различаются по скорости работы, поддерживаемым алгоритмам и моделям тарификации. Для комплексного понимания рынка стоит изучить масштабный обзор инструментов для сбора семантического ядра.
| Инструмент | Тип ПО | Ключевой алгоритм | Преимущества |
|---|---|---|---|
| Key Collector | Десктоп | SERP-overlap, логический | Глубокая настройка парсинга |
| Rush Analytics | Облако | Soft, Hard, ИИ-маркеры | Высокая скорость обработки |
| Key.so | Облако | Soft с маркером | Интеграция с базой конкурентов |
| Топвизор | Облако | Soft, Middle, Hard | Связка с проверкой позиций |
Key Collector остается стандартом для профессиональных SEO-специалистов и агентств. Это десктопное решение предлагает автоматическую и полуавтоматическую группировку по словам, составу фраз и SERP. В последних версиях реализован улучшенный подход с выбором жесткости, однако разработчики не заявляют о наличии встроенных AI-модулей для векторного анализа.
Rush Analytics позиционируется как облачный сервис для быстрой обработки огромных массивов данных. Платформа группирует фразы по пересечению URL в топах с выбором методов Soft и Hard. Искусственный интеллект здесь применяется преимущественно в модулях генерации контента, а не в базовом кластеризаторе.
Key.so ориентирован на массовый рынок и веб-студии. Сервис использует алгоритм мягкой группировки: система выбирает высокочастотный маркер, а остальные фразы должны иметь с ним заданное число общих документов в выдаче. Топвизор предлагает гибкую настройку через силу SERP и порог совпадений, полностью повторяя логику классических методов. Его главное преимущество — бесшовная интеграция с инструментами аналитики, что позволяет сразу отслеживать динамику созданных групп.
Практические примеры кластеризации семантического ядра
Рассмотрим теоретические примеры SEO-картирования, демонстрирующие кардинальные отличия в подходах для разных типов бизнеса. Практика показывает, что слепое копирование структуры конкурентов без учета специфики ниши ведет к провалу.
Пример для информационного портала базируется на методе Soft. Возьмем маркерный запрос «как похудеть». В эту группу органично войдут фразы: «как похудеть за месяц», «как похудеть без спорта», «как похудеть после родов» и «как похудеть в домашних условиях». Алгоритм допускает, что в топ-10 по этим фразам ранжируются разные статьи, но общая информационная потребность аудитории едина. Один объемный лонгрид способен исчерпывающе закрыть все эти вопросы.
Пример для интернет-магазина требует жесткого метода Hard. Маркерный запрос «купить iPhone 15» объединит вокруг себя только точные транзакционные хвосты: «купить iPhone 15 128gb», «iPhone 15 цена» и «iPhone 15 в Москве». Запрос «iPhone 15 pro max купить» будет отсечен в отдельный товарный кластер, так как это совершенно другая модель устройства. Фраза «характеристики iPhone 15» отправится в информационный раздел блога, поскольку выдача по ней состоит из текстовых обзоров, а не из коммерческих листингов.
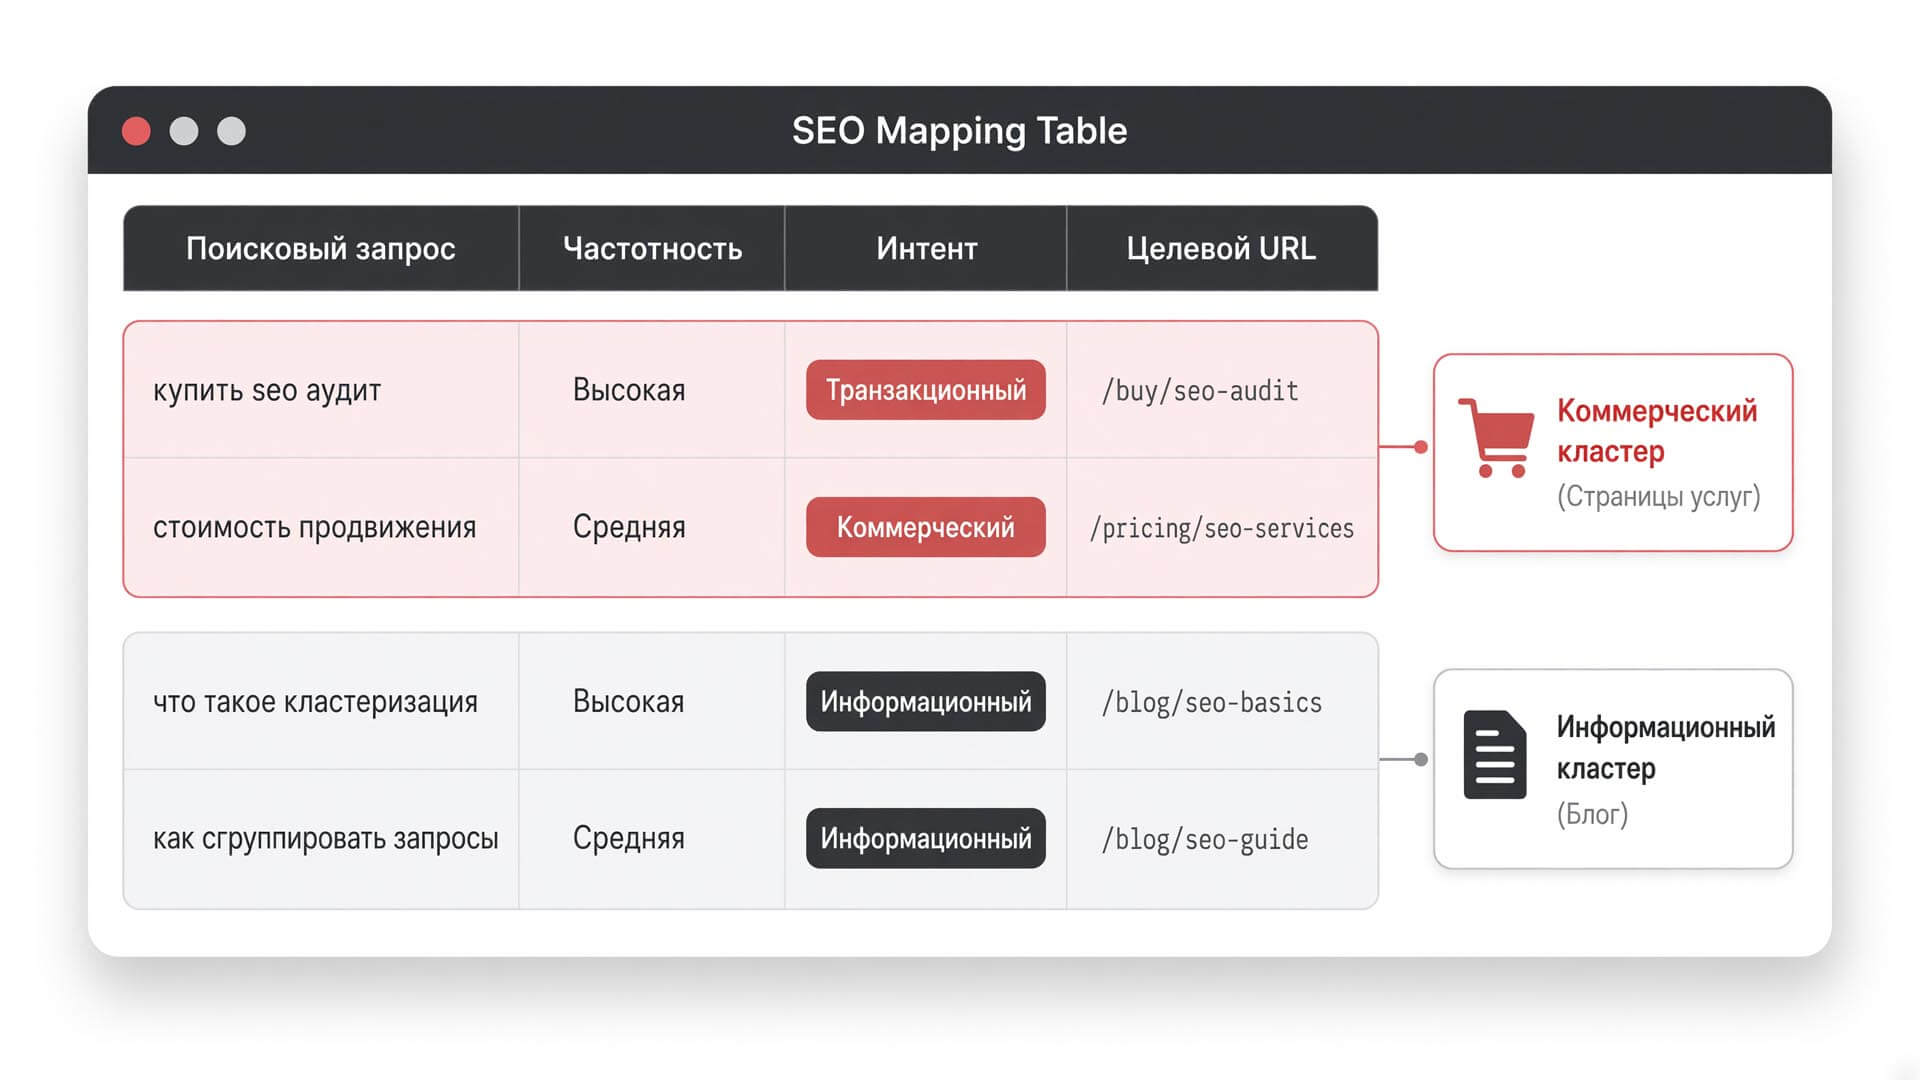
| Кластер | Маркер | Частотность | URL | Интент |
|---|---|---|---|---|
| Коммерческий | купить, цена, заказать | Высокая | /buy/seo-audit | Транзакционный |
| Коммерческий | стоимость, тариф, прайс | Средняя | /pricing/seo-services | Транзакционный |
| Коммерческий | услуги, агентство | Средняя | /services/seo | Коммерческий |
| Информационный | что такое, как, почему | Высокая | /blog/seo-basics | Информационный |
| Информационный | инструкция, гайд | Средняя | /blog/seo-guide | Информационный |
Представленная таблица наглядно демонстрирует жесткое разделение намерений. Коммерческие группы ведут исключительно на страницы услуг и прайс-листов, а информационные направляют трафик в блог. Подобная изоляция гарантирует, что пользователь получит именно тот формат контента, который ожидает увидеть.
Типичные ошибки при группировке семантического ядра и как их избежать
Проблемы с распределением запросов неизбежно приводят к стагнации проекта. Страницы не растут в позициях, а владельцы бизнеса тратят бюджеты на ссылочную массу, игнорируя фундаментальные ошибки в архитектуре. Избежать критических провалов поможет знание типичных антикейсов.
- Слепое доверие автоматике. Машинные алгоритмы регулярно ошибаются при обработке многозначных терминов и смешанной выдачи. Отказ от ручной постмодерации приводит к созданию нерелевантных страниц, которые никогда не попадут в топ.
- Смешивание интентов. Главная ошибка заключается в объединении информационных и коммерческих фраз на одном URL. Гигантские группы с разным смыслом приводят к тому, что документ проигрывает более узко специализированным конкурентам. Решение требует жесткого разделения по коммерческому фактору.
- Игнорирование порога кластеризации. Выбор слишком мягкого порога для интернет-магазина приводит к созданию общих страниц, которые собирают нецелевой трафик и не приносят конверсий. Слишком жесткий порог дробит ядро на сотни слабых страниц, размывая поведенческие факторы и провоцируя фильтры за тонкий контент.
- Отсутствие привязки к бизнес-логике. Сформированные группы обязаны соответствовать реальному ассортименту товаров или услуг компании. Кластер, под который нет реального продукта, будет генерировать отказы.
Косвенной метрикой наличия ошибок является рост каннибализации. Если по множеству запросов одновременно ранжируются 2–3 URL одного сайта, это верный признак потери позиций ядровой страницы. Подобные аномалии легко выявить, если регулярно использовать сервисы, помогающие проверить позиции сайта в динамике.
Предупреждение о рисках
Каннибализация ключевых слов возникает именно при совпадении интента, а не просто из-за похожих слов. Когда несколько страниц конкурируют за одинаковые потребности, алгоритм пессимизирует обе. Игнорирование намерений аудитории гарантирует критически высокий показатель отказов.
Частые вопросы о кластеризации запросов
Что такое кластеризация запросов простыми словами?
Это процесс разбивки огромного списка поисковых фраз на логические группы, где каждая группа идеально подходит для одной конкретной страницы сайта. Фразы объединяют по смыслу и намерениям пользователя, а не по внешнему сходству слов.
Главным ориентиром служит реальная выдача поисковика: если по разным фразам показываются одни и те же документы конкурентов, эти фразы относятся к одному кластеру.
Чем метод Soft отличается от Hard?
Метод Soft связывает запросы исключительно с главным маркерным ключом и допускает, что остальные фразы группы между собой не пересекаются в выдаче. Метод Hard требует наличия общих URL у всех запросов друг с другом, обеспечивая максимальную точность.
Мягкий подход чаще используют для информационных порталов и статейных разделов, а жесткий критически важен для интернет-магазинов и коммерческих каталогов.
Нужна ли ручная проверка после автоматической группировки?
Да, постмодерация специалистом обязательна в 100 % случаев. Машинный алгоритм может ошибиться на омонимах или при анализе смешанной выдачи, а один неверно собранный кластер приведет к созданию нерелевантной страницы.
Специалисту необходимо проверить группу на единство интента, отсутствие информационного шума и адекватность размера.
Как алгоритмы работают с микрочастотными запросами?
Для фраз с нулевой или минимальной частотностью классический анализ выдачи работает плохо. В таких случаях применяются векторные эмбеддинги (LLM), которые группируют фразы по глубокому смыслу и контексту.
Нейросети предсказывают интент редкого запроса, позволяя органично вписать его в существующую структуру сайта.
Как часто необходимо обновлять структуру семантики?
В современных реалиях работа с семантикой перестала быть разовой задачей. Пользовательский спрос меняется стремительно, появляются новые сущности и технологии, требующие регулярного пересмотра структуры.
Рекомендуется проводить аудит и пересборку ядра минимум раз в год, а в динамичных нишах — каждый квартал.
Выводы и рекомендации по эффективной кластеризации семантики
Выводы и рекомендации по эффективной кластеризации семантики сводятся к грамотному симбиозу машинных вычислений и экспертной аналитики человека. Ведущие аналитические агентства прогнозируют полный переход от работы с отдельными ключами к тематическим кластерам, сгруппированным вокруг сущностей. Искусственный интеллект уже способен группировать данные с точностью до 95 %, однако финальное решение об архитектуре проекта всегда остается за специалистом.
Ожидается, что в ближайшие годы AI-ассистенты возьмут на себя всю техническую рутину: от сбора данных до маппинга и выявления контентных дыр. Сама структура сайтов станет динамической, требующей непрерывного пересчета в полуавтоматическом режиме. Чтобы сохранять конкурентное преимущество, придерживайтесь следующих правил:
- Начинайте с глубокой очистки. Мусорные фразы, нерелевантное гео и чужие бренды портят группы еще до запуска алгоритма. Тщательная фильтрация экономит бюджет на продвижение.
- Подбирайте метод под бизнес-модель. Используйте Soft для информационных порталов, Middle для универсальных задач и строго Hard для e-commerce. Всегда тестируйте настройки на небольшой выборке.
- Проверяйте интент вручную. Регулярно открывайте поиск в режиме инкогнито и анализируйте, какие форматы документов ранжируются по запросам вашей группы.
- Изолируйте разный трафик. Информационные и коммерческие потребности должны закрываться на разных URL-адресах. Смешивание ведет к падению конверсии.
- Внедряйте векторный анализ. Использование LLM-эмбеддингов помогает работать с микрочастотными хвостами и значительно повышает шансы ресурса попасть в генеративные AI-ответы поисковиков.
Плати только за фактически достигнутый результат.
Наша цель: лиды, позиции и трафик
Комментарии
Комментариев пока нет. Будьте первым!