Суть процесса и влияние на бизнес
В основе поисковой оптимизации лежит базовое понятие. Индексация сайта — многоэтапный технический процесс, при котором специализированные поисковые роботы обнаруживают, сканируют, анализируют и сохраняют содержимое веб-страниц в структурированную базу данных для последующего участия в ранжировании. Без успешного прохождения этого этапа ресурс фактически не существует для поисковых систем, независимо от качества дизайна или объема вложенных в разработку средств.
Понимание того, что такое индексация сайта, критически важно для оценки рентабельности маркетинговых инвестиций. Актуальные данные показывают, что грамотная техническая оптимизация и ускорение обхода страниц напрямую связаны с ростом органического трафика и окупаемостью SEO. В коммерческом сегменте поисковая оптимизация способна обеспечивать до 825 % ROI, а в сфере B2B SaaS этот показатель достигает 702 % за трехлетний период при среднем сроке окупаемости от четырех до девяти месяцев. Исправление технических ошибок, препятствующих нормальному сканированию, может дать прирост небрендового трафика на 32 % всего за восемь недель.
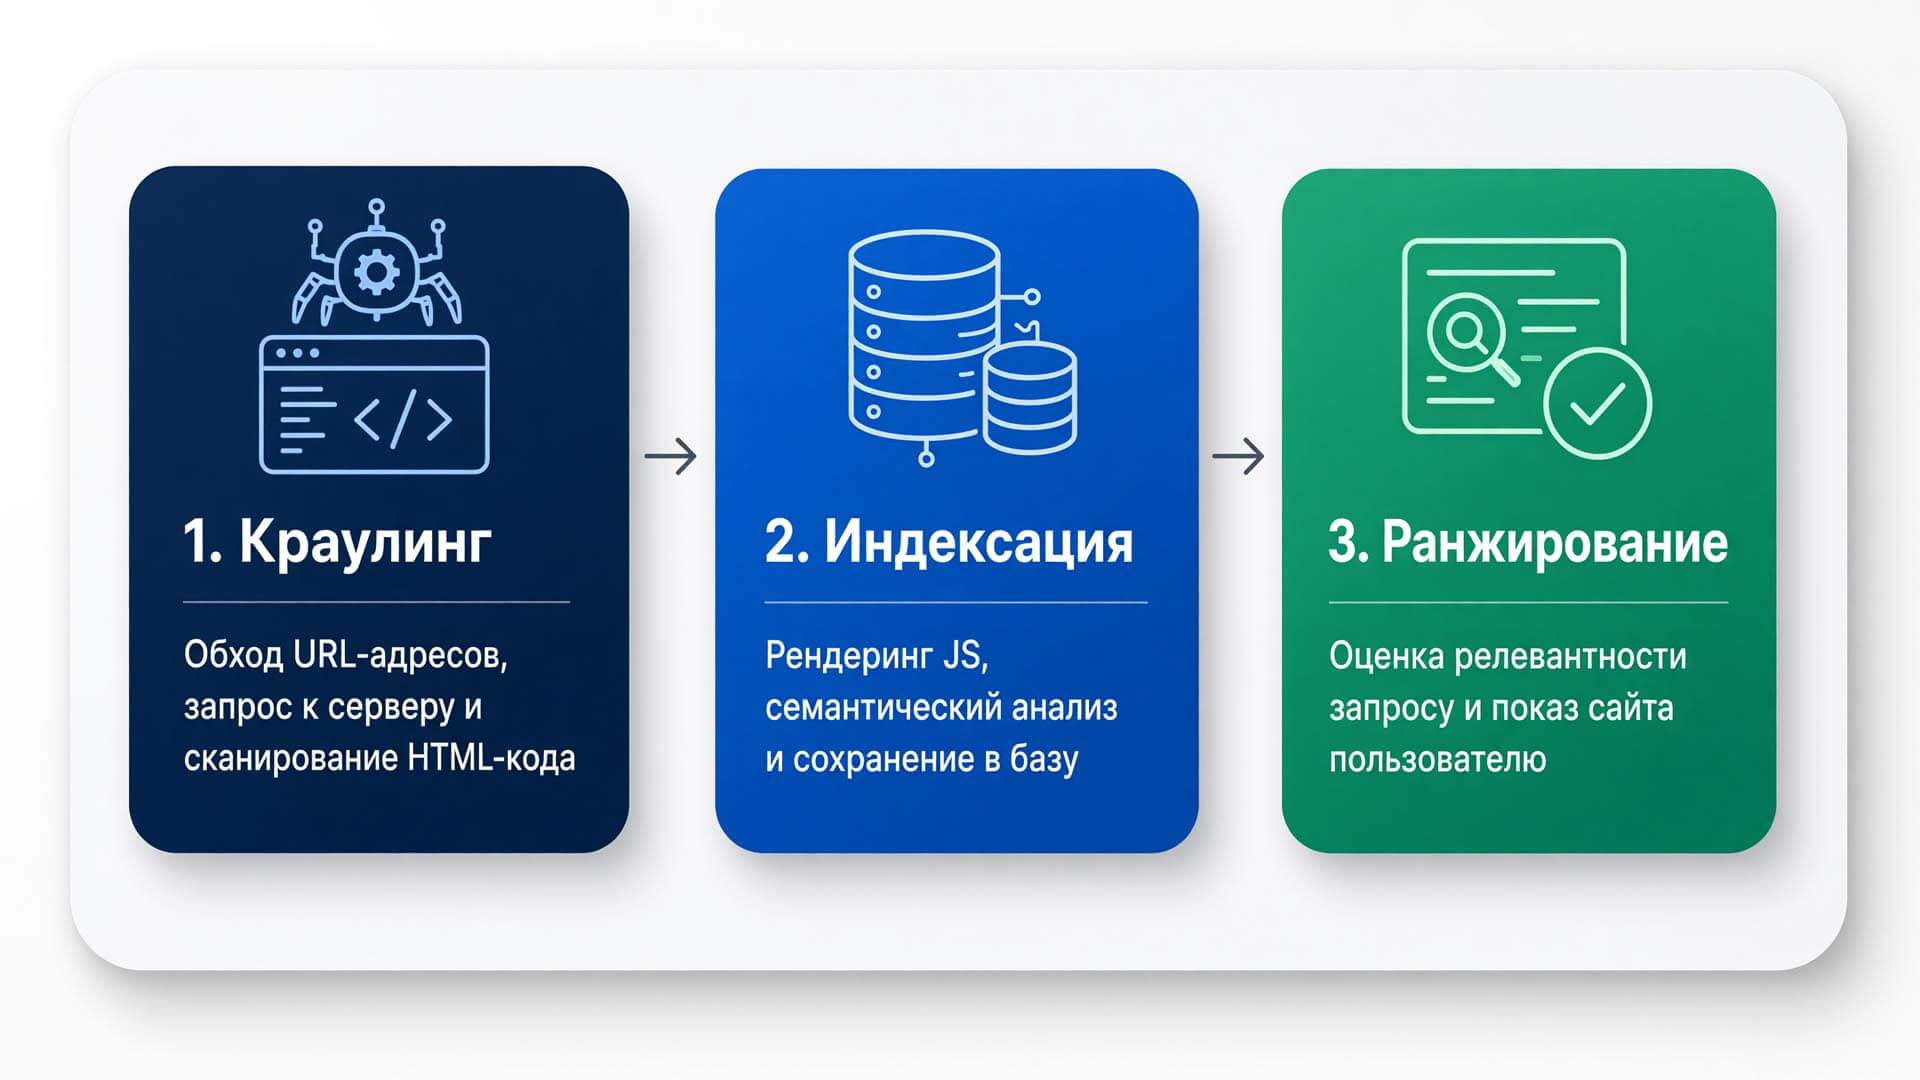
Глобальная архитектура взаимодействия поисковика с веб-ресурсом строится на трех китах. Первый этап — краулинг, когда робот переходит по ссылкам, запрашивает документ у сервера и сканирует исходный код. Второй этап — непосредственно индексирование, включающее рендеринг, извлечение контента, анализ семантики и сохранение данных в индекс. Третий этап — ранжирование, когда алгоритмы оценивают релевантность сохраненного документа конкретному запросу пользователя и определяют его позицию в выдаче. Любой сбой на первом или втором этапе делает третий невозможным.
Алгоритмы обработки данных
Современный пайплайн обработки документа поисковыми системами значительно усложнился по сравнению с прошлыми десятилетиями. Поисковики больше не ограничиваются простым чтением статического HTML-кода. Сегодня они выполняют полноценный рендеринг JavaScript, что особенно актуально для SPA-приложений (Single Page Application), где контент генерируется динамически на стороне клиента. Процесс разделен на две фазы: сначала краулер мгновенно забирает доступный HTML, а затем ставит страницу в очередь на выполнение скриптов через Web Rendering Service.
Существуют строгие технические лимиты, о которых должен знать каждый вебмастер. Основной краулер Googlebot сканирует только первые 2 МБ поддерживаемого текстового файла (HTML, CSS, JS). Для документов в формате PDF лимит расширен до 64 МБ, а для остальных специализированных ботов по умолчанию действует ограничение в 15 МБ. Все ресурсы, на которые ссылается страница, извлекаются отдельно, и к каждому применяется аналогичный лимит. Если критически важный контент или скрипты находятся за пределами этих ограничений, они просто не будут обработаны, что приведет к потере видимости.
Задержка между первой волной сканирования и второй волной рендеринга может составлять от нескольких часов до нескольких недель. Частые проблемы на этом этапе включают пустой исходный код при чистом клиентском рендеринге (CSR), критические ошибки в JS-бандле, недоступность внешних API по таймауту и случайную блокировку важных скриптов в файлах конфигурации. Если вторая волна рендеринга возвращает пустую страницу или неполный DOM-дерево, документ теряет шансы на высокие позиции.
Специфика работы поисковых систем
Несмотря на общие фундаментальные принципы работы, архитектура и приоритеты главных поисковых систем Рунета существенно различаются. Краулеры YandexBot и Googlebot используют разные алгоритмы оценки качества, по-разному распределяют краулинговый бюджет и предъявляют неодинаковые требования к техническому состоянию ресурса.
| Основной краулер | Приоритет индексирования | Инструменты вебмастера | Отношение к JavaScript |
|---|---|---|---|
| Googlebot (Smartphone/Desktop) | Mobile-first Indexing (мобильная версия первична) | Google Search Console | Двухфазный рендеринг через evergreen Chromium |
| YandexBot, YandexAI | Гибридный (баланс платформ и поведения) | «Яндекс.Вебмастер» | Поддерживается, но рекомендуется SSR для надежности |
Особенности сканирования Яндексом
Успешное индексирование сайта в Яндексе требует глубокого понимания специфики отечественного поисковика. YandexBot традиционно обновляет базы несколько медленнее западного конкурента, переиндексация объемных проектов может занимать от суток до недели. Однако система крайне чувствительна к коммерческим факторам ранжирования. Для быстрого попадания в базу коммерческий ресурс обязан содержать прозрачные цены, подробные контактные и юридические данные, исчерпывающую информацию о доставке, оплате и возврате, а также реальные отзывы.
Особое внимание уделяется качеству и полезности контента. Формальная техническая уникальность текста уступила место смысловой ценности: алгоритмы ищут детальные описания, оригинальные медиафайлы и отсутствие шаблонного копипаста. Важную роль играет согласованность NAP (Name, Address, Phone) по всему интернету. Для информационных проектов и медиа Яндекс продолжает поддерживать технологию Турбо-страниц, обеспечивающую мгновенную загрузку контента на мобильных устройствах непосредственно с серверов поисковика.
Особенности сканирования Google
Полноценная индексация сайта в Google неразрывно связана с парадигмой Mobile-first Indexing. Поисковик использует Googlebot Smartphone как основной краулер, оценивая контент, структуру и производительность исключительно по мобильной версии. Если десктопная версия идеальна, а мобильная скрывает часть текста или работает с ошибками, ресурс будет пессимизирован. Скорость входа новых страниц в базу здесь обычно выше, счет часто идет на минуты для авторитетных доменов.
Ключевым техническим требованием выступают метрики Core Web Vitals, которые работают как фактор ранжирования при прочих равных условиях. Алгоритмы строго оценивают скорость отрисовки основного контента (LCP ≤ 2,5 с), задержку взаимодействия (INP ≤ 200 мс) и визуальную стабильность верстки (CLS ≤ 0,1). Медленные сайты не только теряют позиции, но и реже сканируются, так как Googlebot оптимизирует затраты вычислительных ресурсов. Параллельно система жестко фильтрует контент через призму E-E-A-T (опыт, экспертность, авторитетность, достоверность), особенно в тематиках YMYL (Your Money or Your Life).
Мониторинг присутствия в выдаче
Регулярная проверка индексации сайта — это не разовая акция, а постоянный процесс мониторинга технического здоровья проекта. Без систематического контроля невозможно своевременно обнаружить выпадение важных страниц из базы, появление технических дублей или блокировку обхода из-за ошибок сервера. Своевременный аудит статуса URL и общей видимости страниц позволяет предотвратить катастрофическое падение органического трафика.
Для комплексного анализа присутствия ресурса в поисковых базах специалисты используют следующий набор инструментов:
- Google Search Console (Инструмент проверки URL) — предоставляет точные данные о статусе сканирования, времени последнего обхода и обнаруженных проблемах с рендерингом или микроразметкой.
- «Яндекс.Вебмастер» (Проверка статуса URL) — отображает детальную историю обхода страниц роботами YandexBot и YandexAI, включая коды ответа сервера и причины исключения из поиска.
- Операторы поиска (site:вашсайт.ру) — базовый метод для быстрой ручной оценки количества проиндексированных документов и поиска нежелательных поддоменов или служебных директорий.
- Сторонние SEO-сервисы (Ahrefs, Semrush и т. д.) — необходимы для отслеживания динамики видимости, анализа позиций по семантическому ядру и сравнения показателей с прямыми конкурентами.
При массовой проверке статуса URL через API необходимо учитывать жесткие лимиты систем. В Google Search Console API квота на инструмент URL Inspection составляет 2000 запросов в сутки и 600 запросов в минуту на один ресурс. Для крупных проектов с миллионами страниц такой лимит требует грамотной приоритизации проверок: в первую очередь анализируются маржинальные категории, новые карточки товаров и хабовые статьи.
Базовая техническая оптимизация
Правильная настройка индексации сайта формирует надежный фундамент всего технического SEO. Без корректного управления обходом поисковые роботы будут тратить вычислительные мощности на сканирование мусорных страниц, игнорируя действительно важный коммерческий контент. Оптимизация этого процесса требует строгого соблюдения последовательности действий и понимания архитектуры проекта.
Пошаговое руководство для обеспечения оптимальной видимости включает следующие этапы:
- Анализ текущего состояния (сбор данных из панелей вебмастеров, поиск аномалий в логах сервера).
- Создание и оптимизация Sitemap.xml (генерация динамической карты с автоматическим обновлением).
- Настройка Robots.txt (прописывание директив для ограничения доступа к служебным разделам).
- Работа с Google Search Console и «Яндекс.Вебмастером» (верификация прав, настройка региональности).
- Оптимизация контента и структуры (устранение дублей, внедрение канонических тегов).
- Мониторинг и анализ (регулярная проверка отчетов об ошибках сканирования).
Подключение панелей вебмастера
Первым шагом всегда идет верификация прав на управление доменом. Самый надежный и безопасный метод — добавление специальной TXT-записи в настройки DNS-зоны регистратора домена. Этот способ подтверждает владение всем доменом, включая поддомены. Альтернативный вариант — загрузка уникального HTML-файла в корневую директорию сервера. Важно помнить, что удаление этого файла в будущем приведет к потере доступа к статистике в «Яндекс Вебмастере» и консоли Google.
Файлы управления обходом
Критически важно понимать разницу между инструментами управления краулерами. Файл robots.txt — это строгий свод правил обхода. Он использует директивы User-agent для указания конкретного бота, Allow — для разрешения доступа и Disallow — для запрета сканирования определенных путей. В конце файла обязательно указывается абсолютный путь к карте сайта.
В свою очередь, sitemap.xml — это маршрутный лист, содержащий список исключительно приоритетных URL-адресов. Для крупного e-commerce с фасетной навигацией эти два файла должны быть идеально согласованы. В карту сайта включаются только индексируемые страницы, отдающие код ответа 200 OK. Наличие в sitemap адресов, заблокированных в robots.txt, является грубой технической ошибкой, которая дезориентирует алгоритмы.
Золотое правило технического SEO
В файле sitemap.xml категорически не должно быть URL-адресов, которые запрещены для сканирования директивой Disallow в файле robots.txt, а также страниц с настроенными редиректами или каноническими ссылками на другие документы.
Методы ускорения сканирования
Владельцы бизнеса часто задаются вопросом, как ускорить индексацию сайта, особенно при запуске новых проектов или масштабном обновлении ассортимента. Новые страницы могут неделями не попадать в выдачу из-за низкого траста домена или неэффективного расходования лимитов на сканирование. Скорость появления в поиске напрямую влияет на факторы ранжирования и динамику продаж.
Для быстрого привлечения поисковых роботов применяется комплекс эффективных методов:
- Sitemap XML (Карта сайта XML) — автоматический пинг поисковиков при обновлении файла.
- Robots.txt — отсечение мусорного трафика ботов от технических директорий.
- Улучшение скорости загрузки — снижение времени ответа сервера (TTFB) экономит время краулера.
- Качественный контент — алгоритмы быстрее обрабатывают страницы с высокой уникальностью и ценностью.
- Внутренняя перелинковка — создание плотной сети ссылок для беспрепятственного перетекания веса.
- Внешние ссылки (бэклинки) — получение упоминаний с трастовых ресурсов (эффект может проявиться за 1-3 дня).
- Google Search Console / «Яндекс Вебмастер» — использование инструментов принудительной отправки URL.
- Мобильная адаптация — соответствие требованиям Mobile-first для приоритетного обхода.
- Регулярное обновление — формирование паттерна частого сканирования за счет постоянной публикации новостей.
Статистика подтверждает значимость технической оптимизации: снижение времени загрузки страницы всего на одну секунду способно увеличить конверсию на 2 %, а радикальное ускорение с восьми до двух секунд дает прирост конверсии до 74 %. Быстрые сайты сканируются глубже и чаще, так как сервер успевает отдать больше документов за выделенный лимит времени.
Использование IndexNow и API
В 2026 году стандартом для мгновенного уведомления поисковиков стали специализированные протоколы. Протокол IndexNow позволяет отправлять до 10 000 URL-адресов за один POST-запрос. Сигнал автоматически распределяется между участвующими системами: Яндексом, Bing, Seznam и Naver. Для интеграции требуются размещение текстового ключа в корне сайта и настройка отправки HTTP-запросов при публикации или изменении контента.
Поскольку Google не поддерживает IndexNow, для него используется отдельный инструмент — Google Indexing API. Он предназначен преимущественно для сайтов с быстро меняющейся информацией (вакансии, трансляции, новости). Официальная квота составляет 200 publish-запросов в сутки на проект. Превышение лимитов без веских оснований может привести к временной блокировке доступа к API.
Краулинговый бюджет и структура
Краулинговый бюджет — это конечное количество страниц, которое поисковый робот может и хочет просканировать на сайте за определенный промежуток времени. Он зависит от производительности сервера и общей популярности ресурса. Полевые исследования показывают, что на многих крупных проектах всего 15 % страниц генерируют 90 % органического трафика. Остальные 85 % — это мусорные URL (дубли, фильтры, сортировки), которые впустую сжигают лимиты бота.
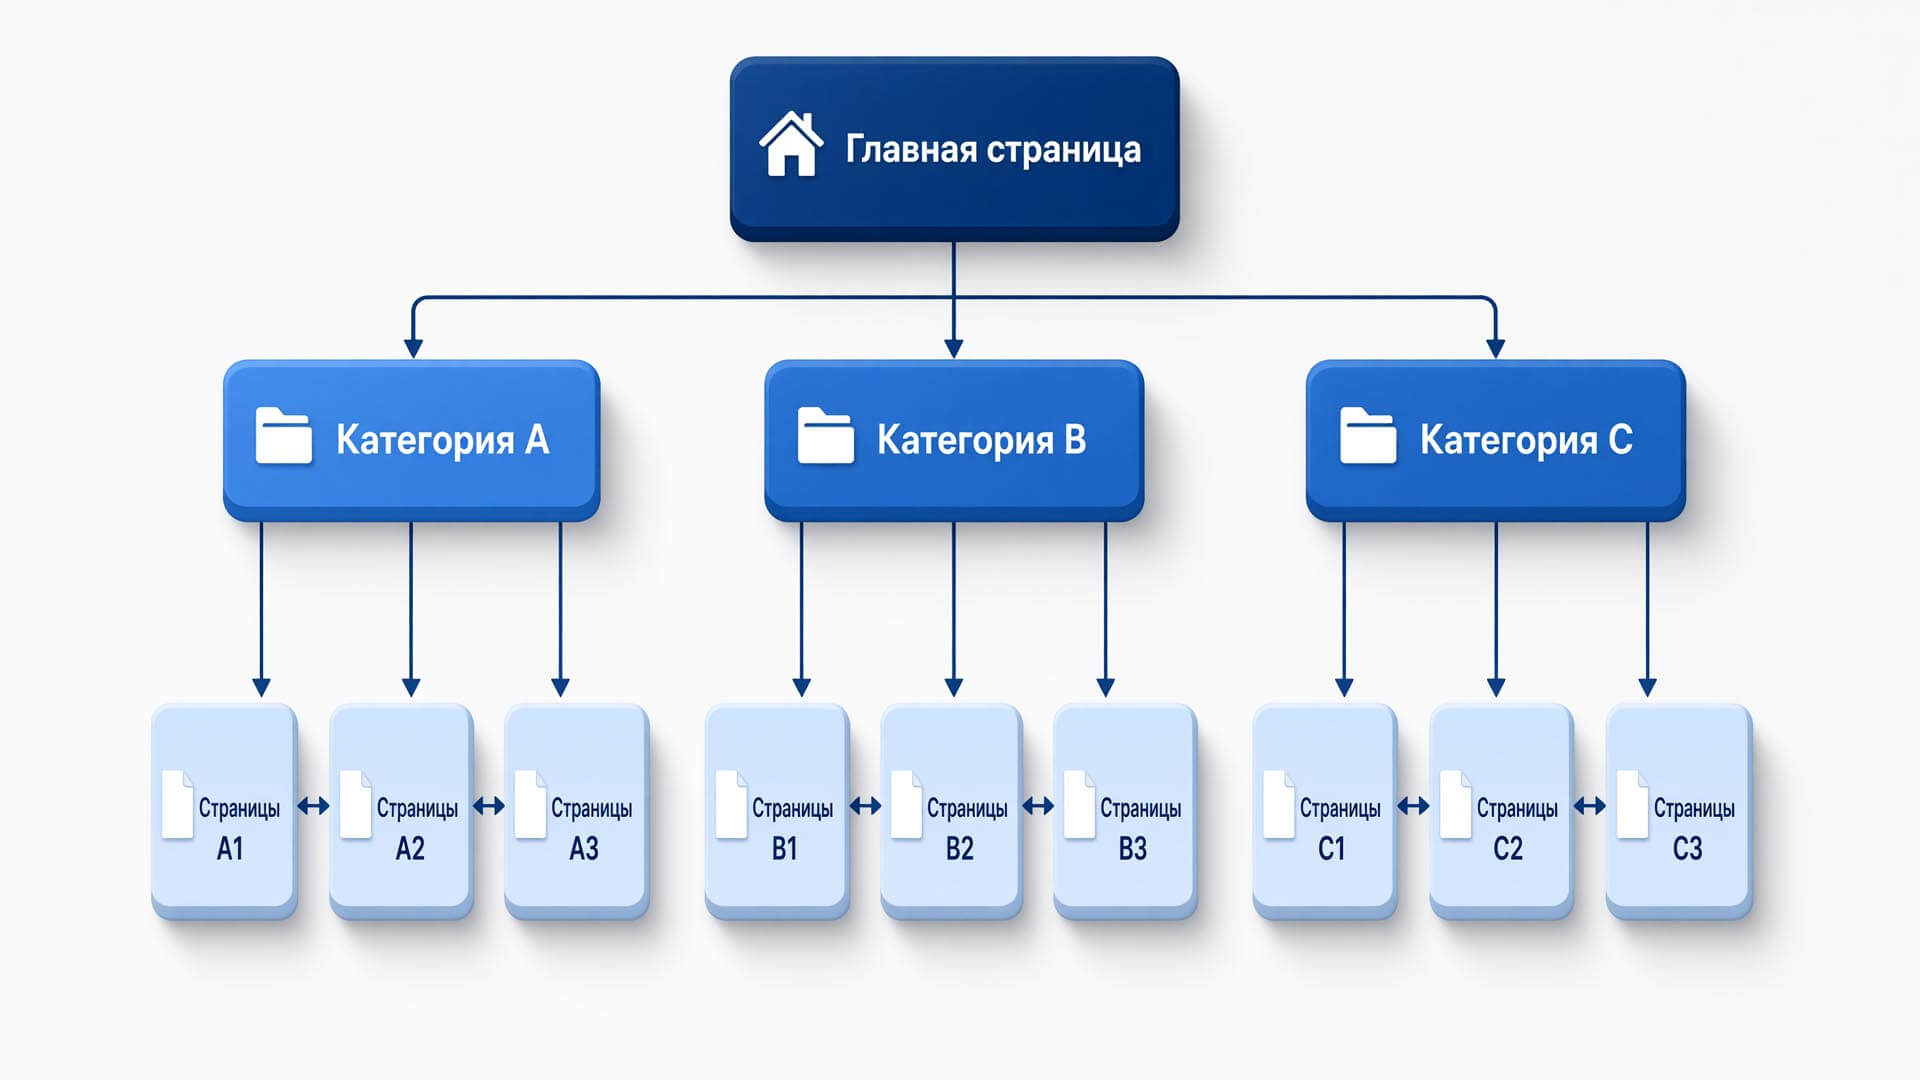
Для грамотного распределения веса применяется Silo-архитектура — жесткая тематическая кластеризация. В этой модели контент строго иерархичен: главная страница ссылается на хабовые разделы (pillar-pages), а те, в свою очередь, на узкоспециализированные статьи или товары. Внутренняя перелинковка замыкается внутри одного тематического кластера, не позволяя ссылочному весу размываться по нерелевантным разделам. Это формирует четкие маршруты для краулеров и повышает тематическую авторитетность каждого силоса.
Исключение страниц из поиска
Вопрос о том, как закрыть сайт от индексации или скрыть его отдельные части, возникает при разработке тестовых сред, создании личных кабинетов или борьбе с техническими дублями. Неправильное скрытие служебных страниц, корзин и бесконечной пагинации приводит к размытию релевантности и каннибализации запросов, когда поисковик не может определить наиболее подходящий документ для выдачи.
Техническое предупреждение
Директива Disallow в файле robots.txt запрещает сканирование содержимого, но не гарантирует удаление URL из индекса. Страница может проиндексироваться по внешним ссылкам и появиться в выдаче без описания. Для полного и надежного удаления документа используйте мета-тег noindex, при этом страница должна быть открыта для сканирования в robots.txt.
Для обеспечения конфиденциальности и предотвращения попадания в выдачу дублированного контента применяются различные методы. Мета-тег robots с директивой noindex размещается в секции head HTML-документа и дает прямую команду алгоритмам не добавлять содержимое в базу. Однако этот метод не работает для не-HTML-файлов, таких как PDF-документы, изображения или видео.
Для медиафайлов и документов Google официально рекомендует использовать HTTP-заголовок X-Robots-Tag. Он настраивается на уровне конфигурации сервера (Apache или Nginx) и передается в заголовках ответа до загрузки самого тела файла.
# Пример настройки X-Robots-Tag для Nginx
location ~* \.pdf$ {
  add_header X-Robots-Tag "noindex";
}
Если требуется абсолютная защита данных (например, для корпоративных порталов или staging-серверов), применяется базовая HTTP-аутентификация (парольная защита). Сервер отдает код 401 Unauthorized, что полностью блокирует доступ любых краулеров к контенту.
Мобильный маркетинг и App Indexing
В эпоху доминирования смартфонов парадигма Mobile-First Indexing диктует свои правила: поисковые системы оценивают веб-ресурсы в первую очередь через призму мобильного пользовательского опыта. Но для крупного бизнеса с собственными приложениями просто адаптивной верстки недостаточно. Здесь на сцену выходит технология App Indexing — связывание URL-адресов веб-сайта с конкретными экранами мобильного приложения.
Эта технология позволяет выводить в поисковой выдаче на смартфонах не просто ссылки на сайт, а кнопки прямого перехода (deep links) в установленное приложение. Для реализации на платформе Android настраиваются Android App Links: на сайте размещается файл assetlinks.json, подтверждающий связь домена с приложением, а в манифесте приложения прописывается intent-filter с параметром autoVerify. Для экосистемы Apple используются Universal Links, требующие размещения файла apple-app-site-association и настройки Associated Domains.
Внедрение App Indexing кардинально меняет путь пользователя. Если приложение установлено, клик в поиске мгновенно открывает нужный товар или статью в нативном интерфейсе, минуя браузер. Если приложения нет, алгоритм может предложить переход в магазин (Google Play или App Store) для его установки, что является мощным инструментом удержания аудитории.
Распространенные технические ошибки
Даже при тщательной настройке проектов возникают сбои, препятствующие нормальному сканированию. Понимание механики работы алгоритмов помогает быстро локализовать и устранить проблему.
Ошибки 404 и Soft 404: как найти и настроить 301 редиректы?
При постоянном ответе сервера 404 (Not Found) удаление URL из индекса происходит не мгновенно. У Google этот процесс занимает от нескольких дней до 2-8 недель, у Яндекса — до 1-3 недель. Если страница переехала, необходимо настроить серверный 301 редирект на новый адрес. Проблема Soft 404 возникает, когда несуществующая страница (например, пустая категория или заглушка) отдает код 200 OK. Алгоритмы классифицируют такие документы как малоценные и медленно выводят их из поиска. Решение — отдавать честный код 404/410 или наполнять страницу реальным контентом.
Почему поисковый бот бросает сканирование при цепочках редиректов?
Цепочки перенаправлений (когда URL A ведет на B, B на C и так далее) критически истощают краулинговый бюджет. Официальные лимиты Googlebot строго ограничены: робот следует максимум по 10 шагам редиректов за один проход. После превышения этого лимита сканирование принудительно обрывается, конечная страница остается неизвестной поисковику. Для устранения ошибки необходимо проанализировать логи сервера и заменить все многоступенчатые перенаправления на прямые ссылки (от URL A сразу к конечному URL).
Почему новые домены медленно попадают в индекс (проблема Sandbox)?
Эффект «песочницы» (Sandbox) проявляется в том, что страницы нового домена сканируются, но крайне неохотно добавляются в основную базу и получают низкие позиции. Алгоритмы защищают выдачу от спама, требуя времени на оценку траста ресурса. Решение заключается в планомерном наращивании качественной ссылочной массы, публикации экспертных материалов и привлечении стартового трафика. Изучая методы продвижения сайтов, можно отметить, что выход из «песочницы» обычно занимает от 4 до 9 месяцев системной работы.
Анализ логов сервера — единственный достоверный способ узнать, как именно поисковые боты взаимодействуют с вашим ресурсом. Панели вебмастеров показывают лишь агрегированную и часто запаздывающую статистику, тогда как сырые логи (access.log) раскрывают реальную картину расходования краулингового бюджета по секундам.
Важный аспект оптимизации
Неконтролируемое создание страниц под низкочастотные запросы без достаточной уникализации контента неизбежно приводит к проблеме, известной как каннибализация запросов. В этом случае алгоритмы не могут выбрать наиболее релевантный документ, что ведет к взаимной пессимизации страниц внутри одного домена.
Итоговые выводы
Управление видимостью ресурса в поисковых системах — это непрерывный аналитический и технический процесс. Базовая настройка файлов обхода и мониторинг логов сервера закладывают основу для успешной реализации любой маркетинговой стратегии. Подводя итоги, выделим ключевые тезисы:
- Понимание архитектуры поисковых систем и лимитов на рендеринг JavaScript критично для современных веб-приложений.
- Google и Яндекс имеют разные приоритеты: первый ориентирован на Mobile-first и Core Web Vitals, второй — на коммерческие факторы и поведенческие метрики.
- Для массовой проверки статуса URL необходимо использовать API панелей вебмастеров, учитывая суточные квоты на запросы.
- Ускорение обхода достигается за счет оптимизации скорости ответа сервера, внедрения IndexNow и грамотной перелинковки.
- Построение жесткой Silo-архитектуры позволяет направить краулинговый бюджет на маржинальные страницы, отсекая технический мусор.
- Для надежного исключения документов из поиска следует применять мета-тег noindex или заголовок X-Robots-Tag, а не директиву Disallow.
Системный подход к техническому SEO, регулярный аудит ошибок и адаптация под новые требования алгоритмов гарантируют стабильный рост органического трафика. Детальная проработка каждого из этих пунктов входит в обязательные этапы SEO-продвижения сайта, обеспечивая долгосрочное лидерство в конкурентных нишах.
Комментарии
Комментариев пока нет. Будьте первым!